Fine Day 2025: почему корпоративной аналитике нужны проверяемые ИИ‑агенты
На конференции Fine Day обсудили переход от self-service аналитики к AI-native подходу, контроль ответов ИИ, подготовку данных и новые инструменты миграции BI.
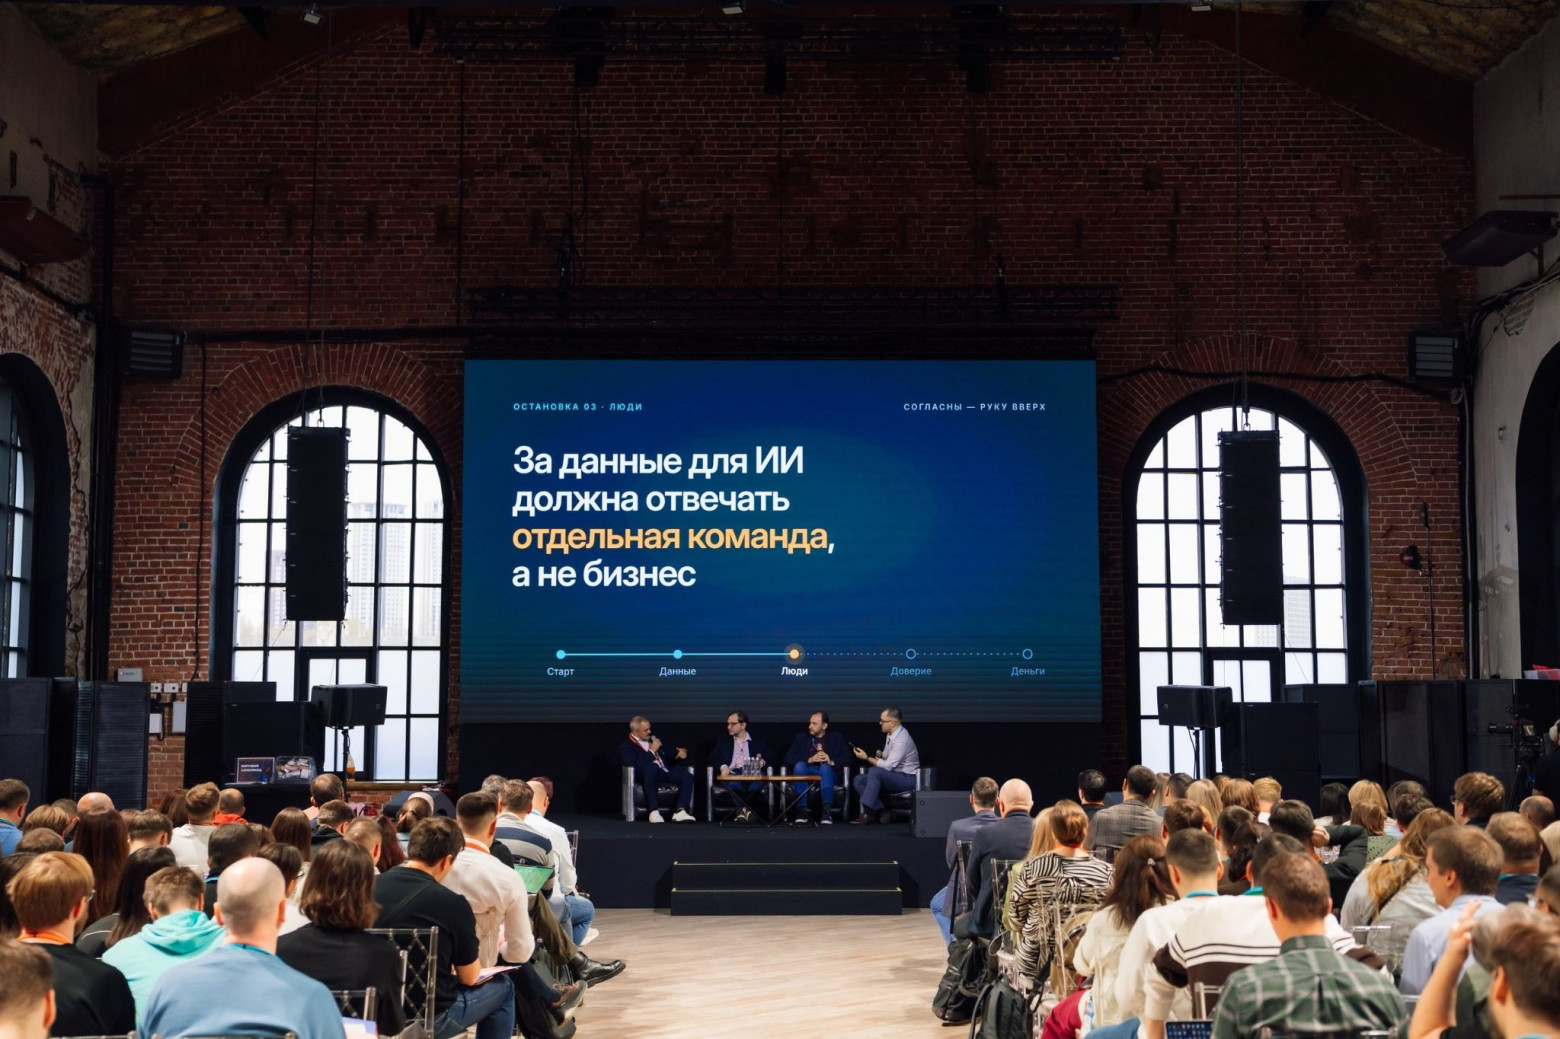
23 октября в Москве прошла пятая конференция Fine Day, организованная GlowByte. Главной темой мероприятия стал переход от self-service аналитики — самостоятельной работы пользователей с данными — к AI-native подходу, в котором ИИ изначально закладывается в архитектуру корпоративной аналитики.
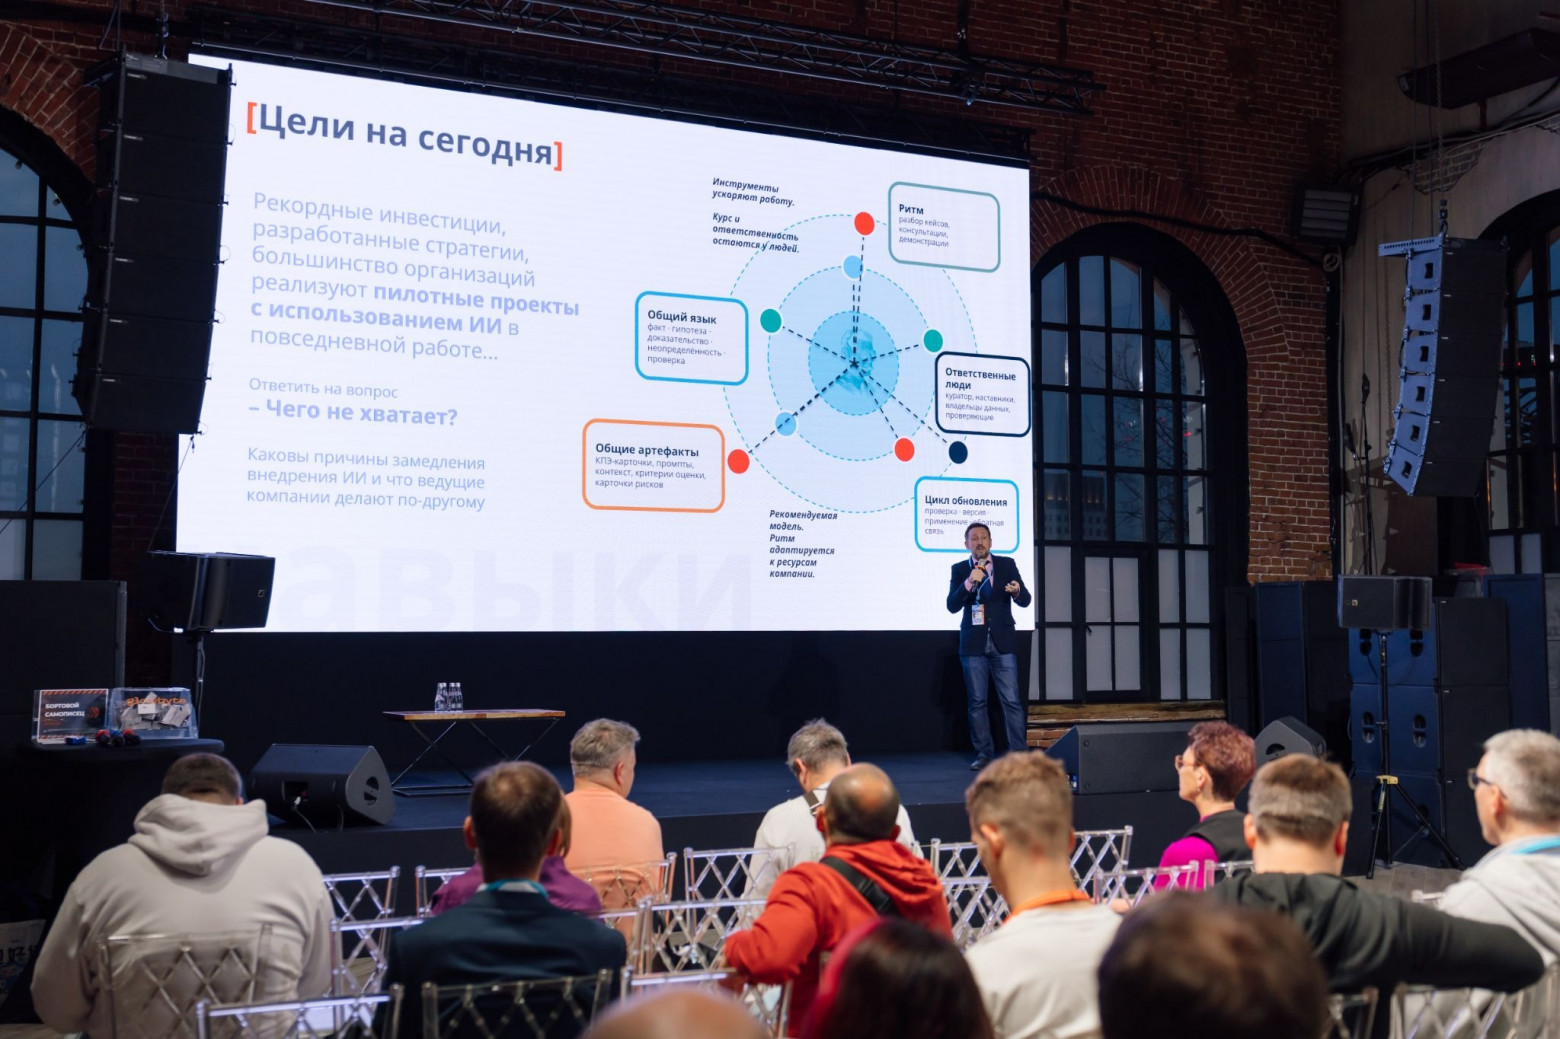
Конференцию посетили около 250 человек: руководители аналитических подразделений крупных компаний, специалисты по данным и бизнес-аналитике. Участники обсуждали, какие условия необходимо создать до запуска ИИ-агентов, кто должен отвечать за подготовку данных и как проверять выводы моделей перед тем, как использовать их в управленческих решениях.
Главная проблема — не получение ответа, а его проверка
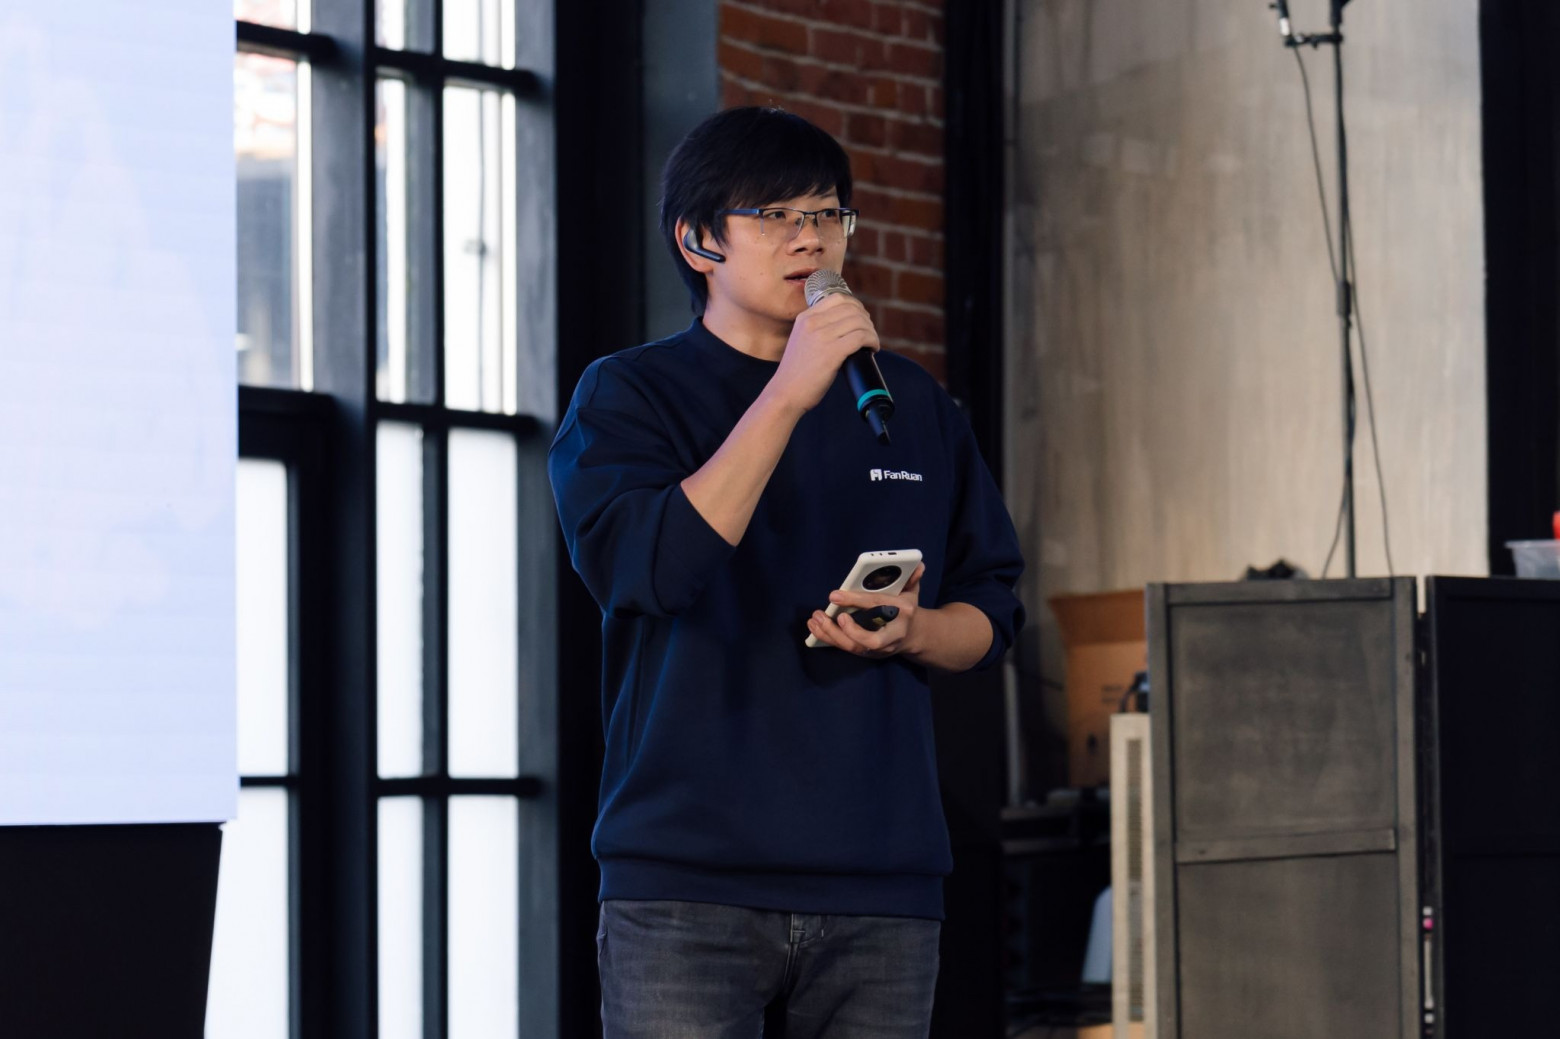
Международный директор по продукту и зарубежной стратегии FanRuan Лэнс Ли в докладе «От инсайта к действию: построение доверенного корпоративного ИИ» отметил, что стоимость ответов ИИ снижается, тогда как дефицитным ресурсом становится возможность подтвердить их корректность.
В 40 тестовых запусках FanRuan десять ответов не прошли полную сверку с исходными данными. В другом эксперименте четыре инструмента на один вопрос о прибыли выдали разные результаты — от 31,8 до 34,0 млн юаней. По мнению Ли, поэтому корпоративному ИИ нужен агент, который показывает не только итог, но и весь ход анализа: использованные данные, примененные фильтры и связи, а также рассчитанные показатели.
Такой принцип FanRuan реализует в платформе дата-агентов Dora и планирует развивать в следующей версии FineBI, выпуск которой запланирован на 2027 год. Проверяемость должна стать частью результата наравне со скоростью и точностью: пользователь должен иметь возможность понять, откуда взялась цифра, и при необходимости исправить отдельный шаг анализа.
Пять условий для запуска ИИ в аналитике
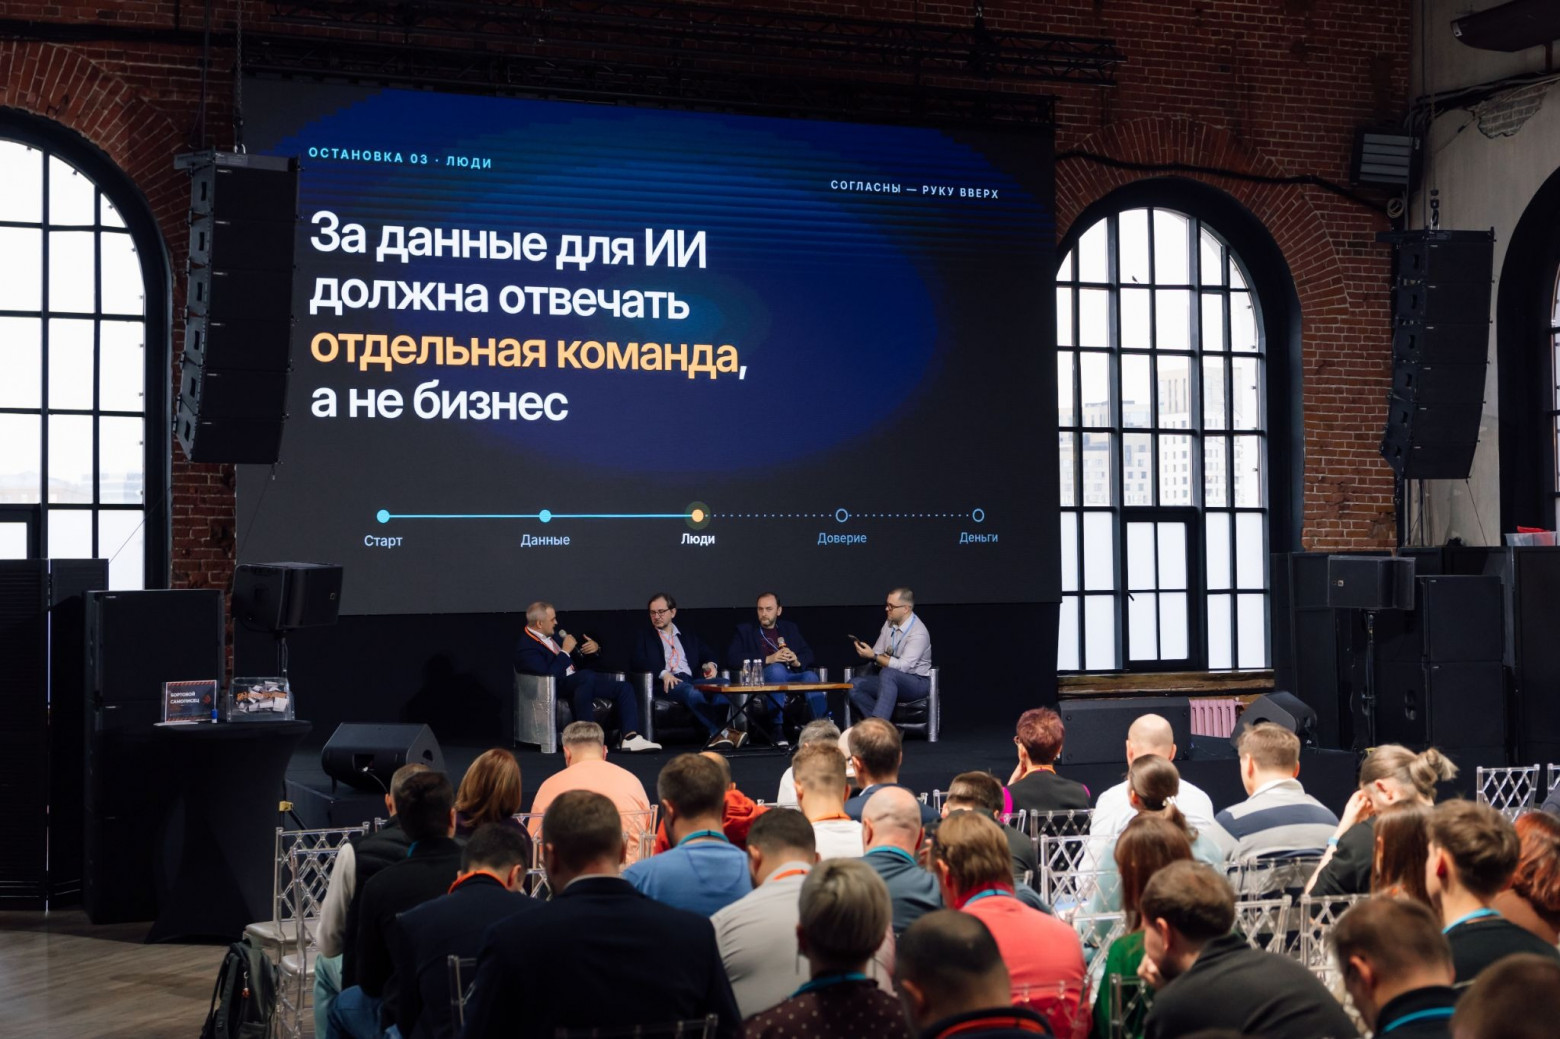
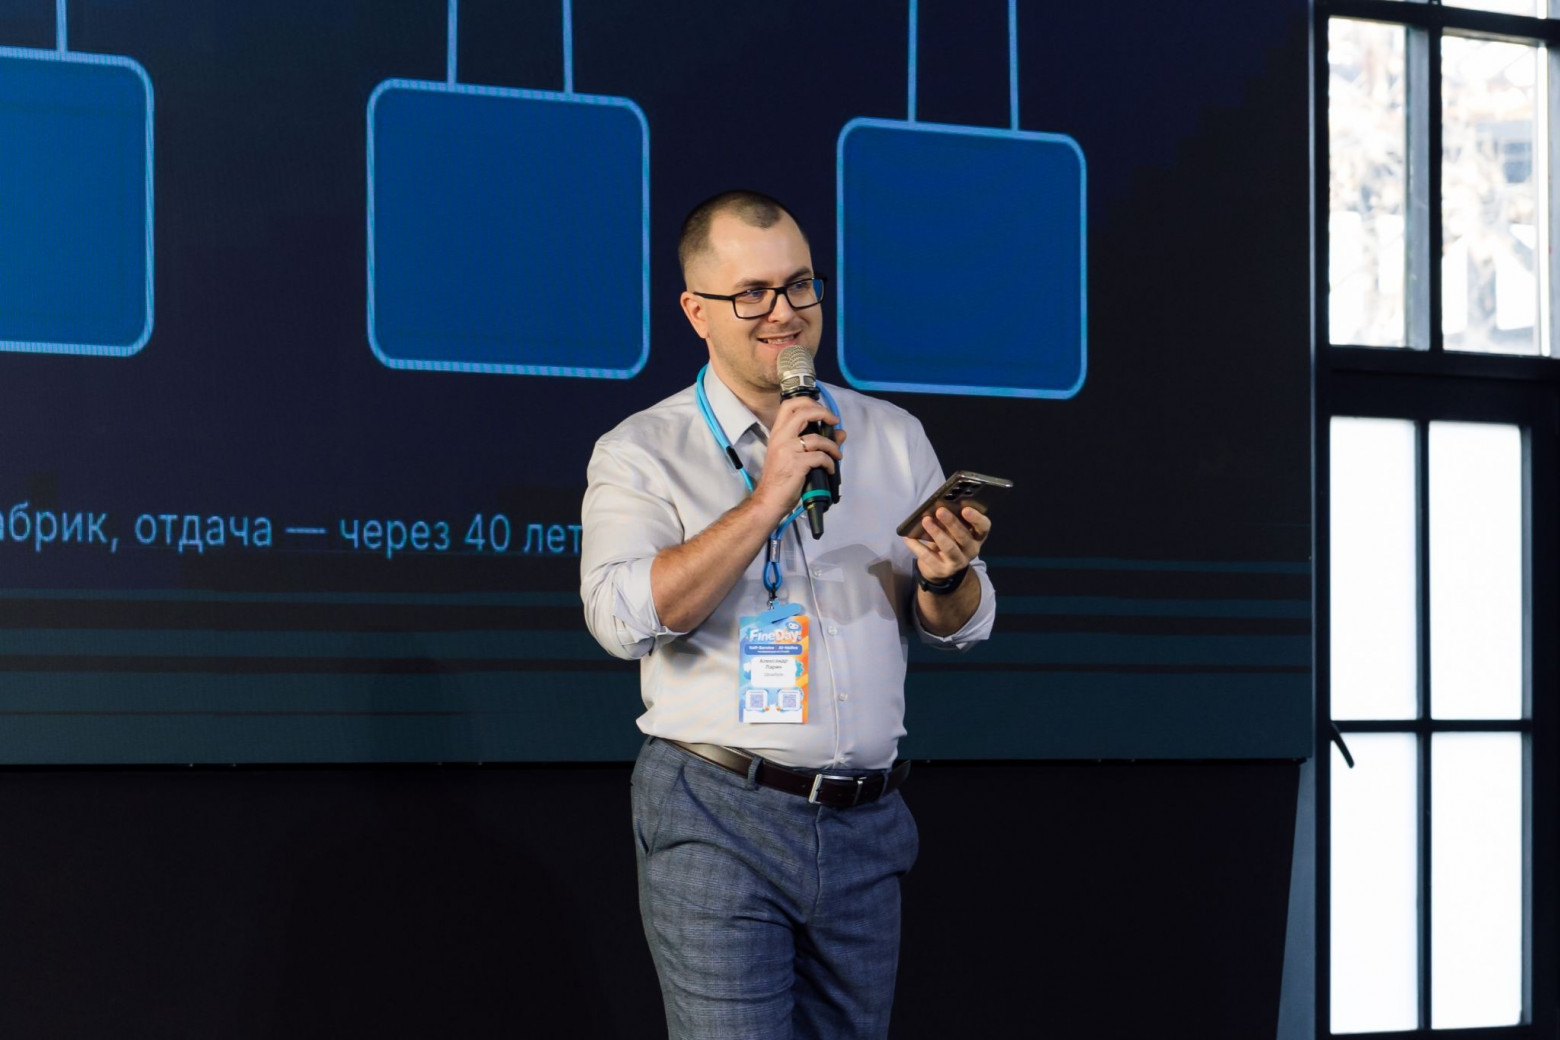
На круглом столе «AI-Ready: что нужно данным и командам, чтобы ИИ заработал» руководители бизнес-аналитики из ПИК, «Дикси» и «АвтоВАЗа» разобрали путь типичного ИИ-проекта. Модератором выступил Александр Ларин, руководитель центра поддержки и обучения GlowByte.
Дискуссия была построена вокруг пяти этапов: старт, данные, люди, доверие и деньги. Отправной точкой стал практический вопрос руководителя: почему в сентябре снизилась маржа в Центральном регионе. Агент может ответить на него за секунду, однако основным предметом обсуждения стала не скорость, а надежность такого ответа.
Участники рассмотрели несколько спорных тезисов: первым сценарием для ИИ-агента должен быть максимально простым и рутинным; ключевой проблемой аналитического ИИ остается качество данных; ответственность за данные нельзя полностью перекладывать на отдельную техническую команду; внедрение ИИ сначала создает новые расходы, а не автоматически сокращает затраты.
В качестве практического итога участники сформулировали пять ориентиров: сценарий, смыслы, хозяин, проверка и отдача. Компаниям необходимо заранее выбрать конкретный сценарий, договориться о значении показателей, назначить ответственных за данные, организовать проверку результатов и понимать, какую пользу дает проект.
Александр Ларин также отметил, что ИТ постепенно меняет роль. Пользователи все реже ждут готовый отчет по заявке и все чаще собирают его самостоятельно с помощью ИИ. Поэтому задача ИТ смещается от ручного создания каждого отчета к построению инфраструктуры, инструментов и среды с проверенными данными, в которой бизнес может работать автономно.
Миграция BI-отчетов с помощью Morphism AI
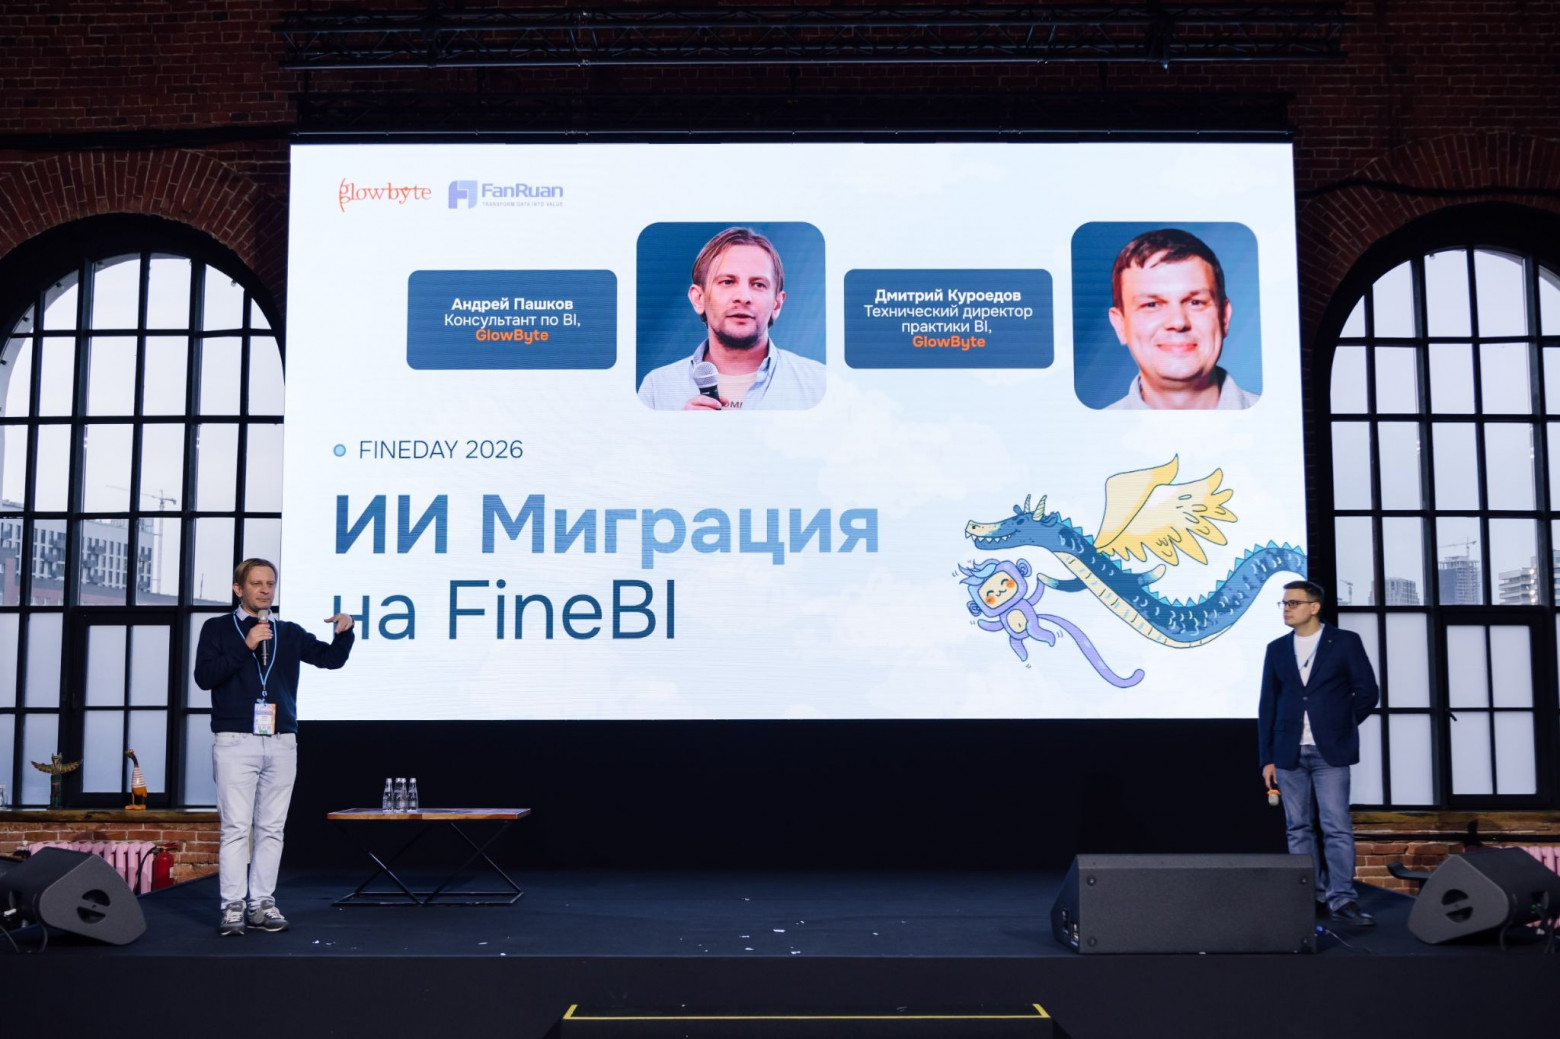
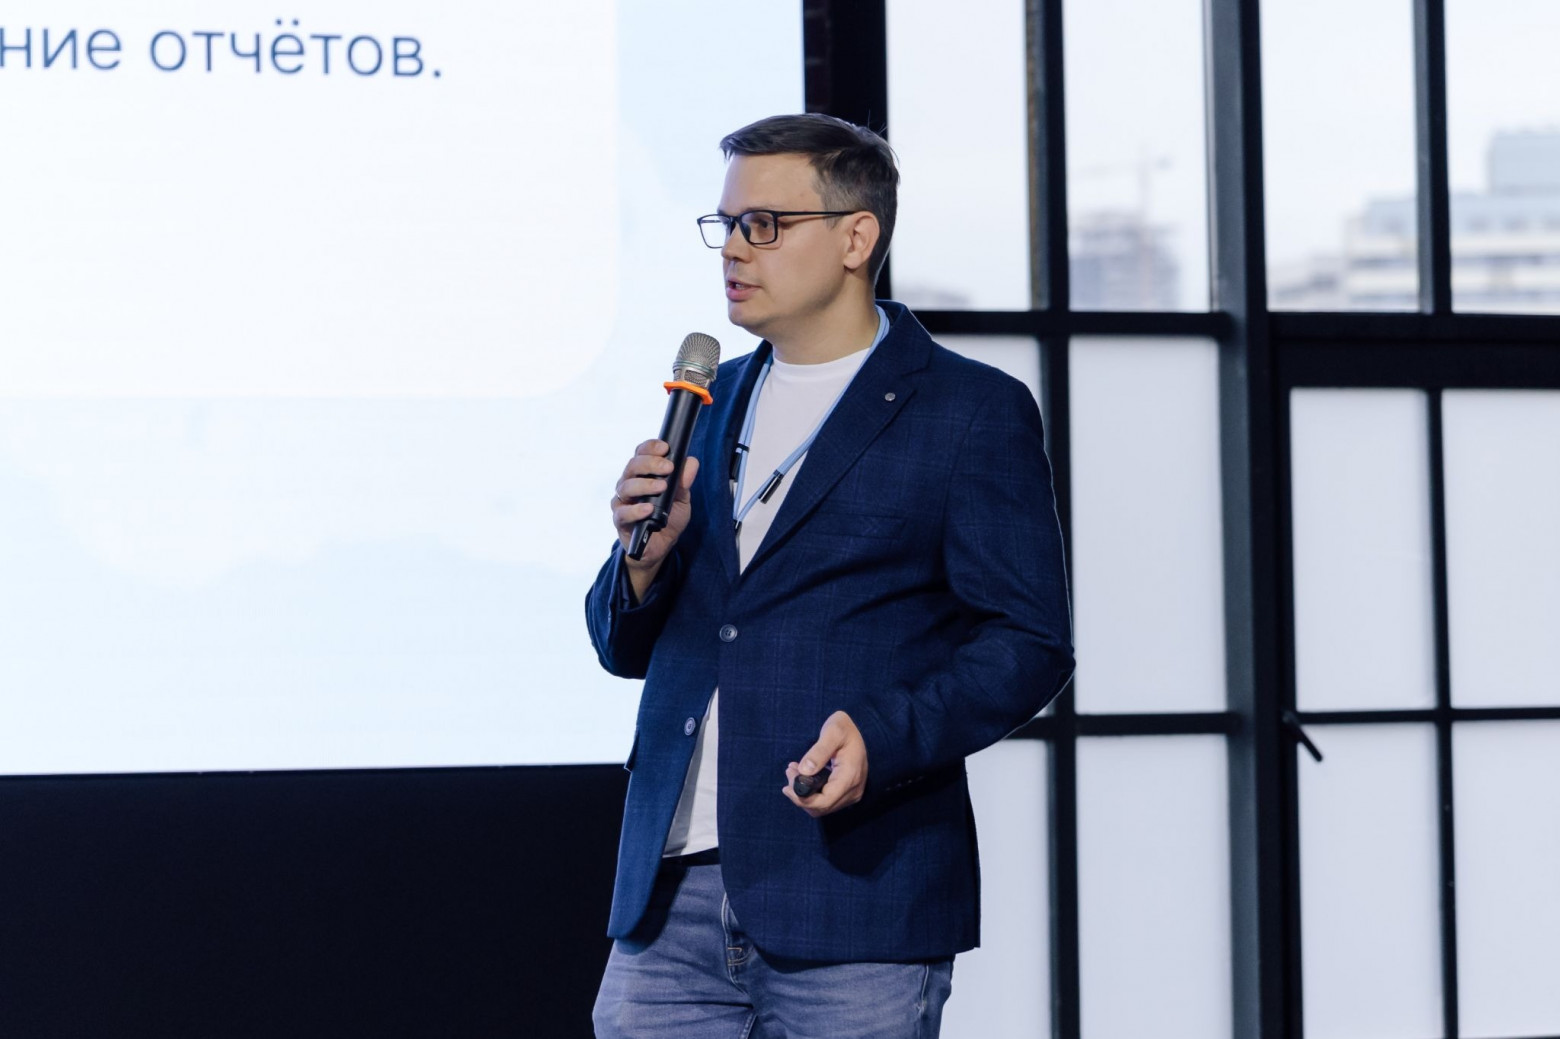
Технический директор GlowByte Дмитрий Куроедов и консультант компании Андрей Пашков представили Morphism AI — инструмент для автоматизированного переноса BI-отчетности из QlikView, Qlik Sense и Power BI на FineBI. Решение основано на более чем десятилетнем опыте проектов внедрения бизнес-аналитики и экспертизе по платформе FineBI.
ИИ-модель при переносе работает только с описанием и структурой отчетов, а ключевые решения принимает специалист. Логика загрузки данных преобразуется в витрины на открытом стандарте dbt с поддержкой PostgreSQL, Trino, StarRocks и ClickHouse. Визуализации и показатели переносятся в дашборды FineBI, после чего комплект разворачивается на тестовом стенде и проходит повторную сверку.
На каждом этапе исходная система и новые витрины рассчитывают показатели на одинаковых синтетических данных. Модель анализирует расхождения и предлагает исправления. По оценке GlowByte, автоматически переносится более 90% ETL-скриптов и свыше 85% визуализаций Power BI. Для каждой из 469 функций DAX определено, возможен ли точный перенос, перенос с заменой или требуется доработка.
Morphism AI предназначен для быстрых пилотов и массовой миграции сотен и тысяч отчетов. Подключение новой исходной системы или целевой платформы занимает примерно месяц. В следующей версии разработчики планируют добавить перенос на уровень центра данных FineBI, включая корпоративные семантические слои.
Где заканчивается BI и начинается LLM
Начальник управления развития и сопровождения аналитических систем Московской биржи Александр Нугаев разделил задачи дата-аналитики по двум параметрам: цене ошибки и повторяемости. Он выделил четыре класса: регламентную отчетность на сертифицированных витринах, быстрые ответы по выверенным метрикам с помощью GenBI, нестандартные регулярные дашборды и разовую продуктовую аналитику в песочнице с большой языковой моделью.
Вайб-кодинг дашбордов, то есть создание визуализаций с помощью ИИ, спикер назвал не отдельным классом задач, а способом производства. По его оценке, около 90% усилий при создании дашборда приходится на анализ, архитектуру, интеграцию, настройку доступа и управление данными. ИИ в основном ускоряет оставшиеся 10% — написание кода визуализации.
Регламентную отчетность, считает Нугаев, нельзя передавать языковой модели. Дашборд является зафиксированным вычислительным контрактом и должен выдавать одинаковый результат завтра и через год, тогда как поведение модели по своей природе недетерминировано. Кроме того, каждый ответ LLM требует отдельного запуска модели. Если 200 пользователей открывают панель пять раз в день, это может составить около 20 000 обращений в месяц и примерно 0,6 млрд токенов.
Поэтому часто повторяющиеся вопросы следует превращать в регламентные дашборды, а регулярные обращения к GenBI — в заявки на новые метрики. Для безопасной работы такого контура необходимы единый семантический слой, наследование прав доступа, аудит по схеме «кто — что — зачем», маршрутизатор, который сначала ищет готовый отчет, и телеметрия повторяющихся вопросов.
Данные для ИИ: CI/CD и локальные модели
Петр Гордиенко и Евгений Иванов из ОТП Банка рассказали, как компания готовит данные для ИИ с помощью процессов CI/CD в FineBI. Ранее аналитики напрямую работали с производственными базами и могли изменять наборы данных, что увеличивало нагрузку, создавало теневое хранилище и приводило к поломкам отчетов из-за несогласованных правок.
Теперь разработка ведется только в тестовом контуре. В производственную среду набор данных попадает после проверки кода в Bitbucket: для него создаются отдельная ветка и заявка на ревью, а после одобрения публикация выполняется автоматически. Банк также разработал SQL Optimizer — ИИ-помощника для проверки SQL-запросов на локальной модели Qwen 27B, благодаря чему данные не передаются наружу.
Дополнительные алгоритмические правила повышают надежность проверки. При четырех вариантах запроса с контролем правильными оказывались 100% результатов, тогда как при одном варианте без проверки — только 20%. Карточки отчетов и сведения о происхождении данных хранятся в Data Ocean.
После внедрения нового процесса нагрузка на производственные базы со стороны FineBI снизилась примерно на 30%, а ревью занимает около одного рабочего дня. Проверенные наборы данных постепенно формируют семантический слой, необходимый для работы языковых моделей. Следующим этапом ОТП Банк планирует пилот Dora для подготовки отчетов, проверки ответов и генерации дашбордов.
Человеческая ответственность остается обязательной
Основатель проекта DataYoga Андрей Демидов отметил, что сотрудники уже используют ИИ во многих компаниях, но делают это с разной глубиной и без единых правил проверки. Главный риск, по его мнению, связан не с нехваткой технологий, а с отсутствием общей практики и распределенной ответственности.
Грамотность аналитика он предложил рассматривать как сочетание трех навыков: работы с данными, работы с ИИ и ответственного принятия решений. Специалист должен уметь сформулировать вопрос, подготовить контекст, направить модель, проверить результат, объяснить неопределенность и принять ответственность за итог.
Общий вывод конференции сводится к тому, что ИИ не отменяет корпоративную аналитику и не заменяет ее фундамент. Для надежной работы агентам нужны качественные данные, семантические слои, понятные права доступа, аудит и человек, который отвечает за смысл и проверку результата. ИИ может ускорить получение ответа, но доверие к нему возникает только тогда, когда каждый важный шаг анализа остается доступным для контроля.
Сообщить о проблеме в публикации
Обращение принято Обращение будет рассмотрено. По результатам проверки публикация может быть исправлена, дополнена, временно скрыта или удалена.