Perfscale v0.30.0: пользовательские шаги, Node.js и новые возможности нагрузочного тестирования
В Perfscale v0.30.0 появились пользовательские use:-шаги, запуск Node.js и Python, типизированные inputs, работа с несколькими IP и исправления для arrival.
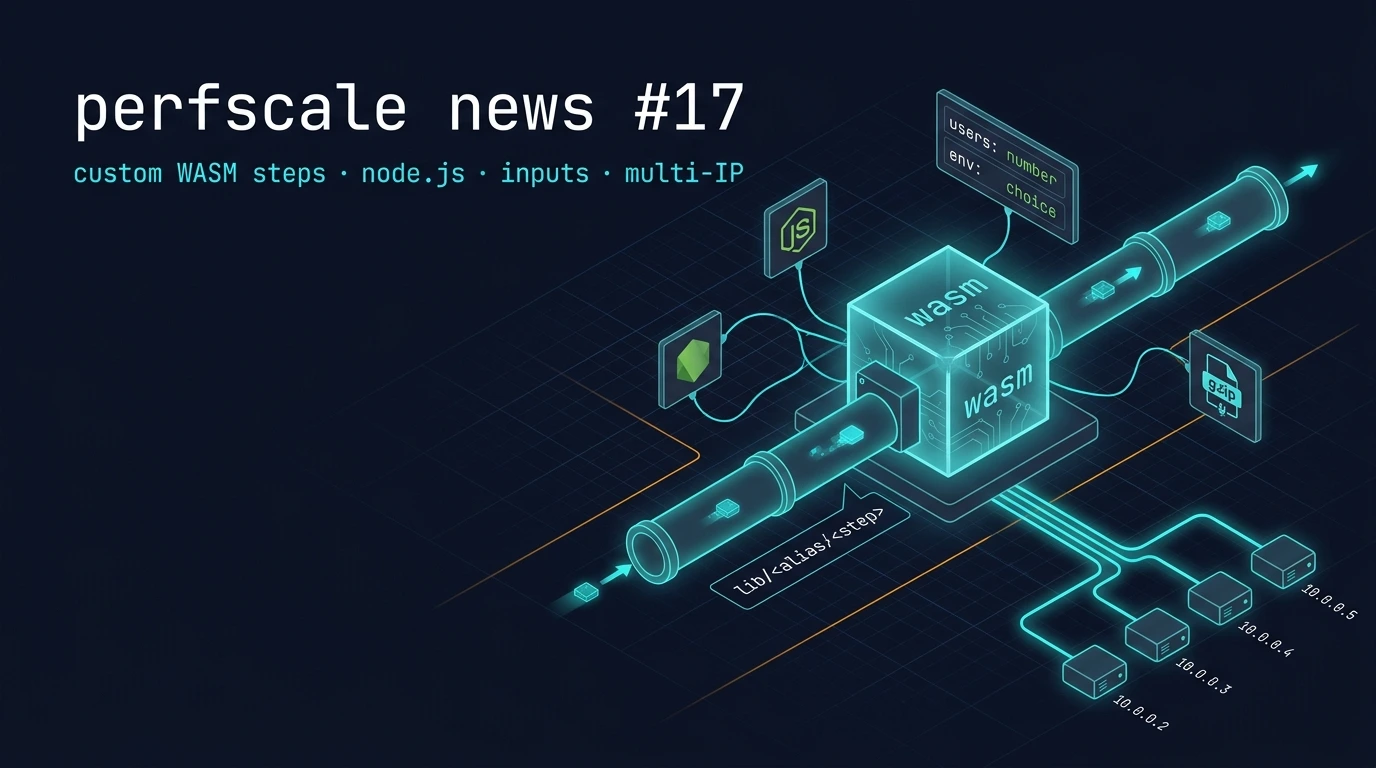
В Perfscale v0.30.0 появился механизм, которого не хватало для нестандартных сценариев нагрузочного тестирования: теперь пользователи могут создавать собственные шаги use: с логикой, проверками и метриками. Раньше расширять сценарии можно было в основном через генераторы значений, а для более сложных задач требовались изменения в самом движке или отдельные pro-модули.
Новый механизм реализован в рамках RFC 009. WASM-компоненты теперь могут экспортировать не только функции-генераторы, но и полноценные шаги, вызываемые из сценария через конструкции вида lib/<alias>/<step>. Префикс lib/ пока используется экспериментально, чтобы отделять стандартные библиотеки от пользовательских.
Запуск внешних процессов и библиотеки Node.js и Python
Для задач, связанных с внешними программами, появилась capability process. Она позволяет однократно запускать процесс через хост, ограничивая объём вывода и время выполнения, а также завершая дерево дочерних процессов. Режим считается доверенным и включается только при одновременном выполнении трёх условий: наличии гранта в YAML, параметра allow_library_capabilities: true и параметра allow_process_actions: true.
Первой библиотекой с поддержкой этого механизма стала Perfscale/nodejs. Она скачивает официальный релиз Node.js, проверяет SHA-256 по файлу SHASUMS256.txt до распаковки, сохраняет архив в локальный кэш и предоставляет три варианта запуска: выполнение inline-скрипта через node -e, запуск файла нужной версией Node.js и установка пакета с последующим запуском.
Запуски выполняются без shell: каждый процесс получает явный массив аргументов и окружение, а переменные хоста автоматически не наследуются. Сейчас поддерживаются Linux x86_64 и aarch64. Авторы отдельно предупреждают, что такие шаги предназначены для подготовки фикстур, генерации данных и разовых проверок, а не для горячего пути на тысячи RPS: каждый вызов создаёт настоящий внешний процесс и снижает производительность генератора.
Библиотека Perfscale/python строится по той же модели. Она использует официальный standalone CPython, проверяет контрольную сумму и изолированно устанавливает окружение. Репозиторий уже создан, но библиотека пока находится в разработке.
Faker и типизированные параметры запуска
Библиотека Perfscale/faker предназначена для генерации тестовых данных: адресов электронной почты, физических адресов и тестовых платёжных реквизитов. Подключать такие библиотеки можно через официальный GitHub Action, который теперь умеет загружать пользовательские библиотеки из GitHub Releases.
В конфигурации также появились типизированные параметры прогона. Шаги получают их через выражения ${'{'}{ inputs.<name> {'}'} }, а значения можно передавать при запуске. Приоритет следующий: параметр -i в командной строке, затем env-файл через -e, затем значение default. Из env-файла используются только ключи, объявленные в конфигурации, поэтому допускается общий файл окружения.
Проверка выполняется до начала нагрузки. Ошибкой считаются пропущенный обязательный параметр, неизвестный ключ, значение неправильного типа, выход за пределы min/max или вариант, отсутствующий в списке choice. Пока inputs можно использовать в with: и check:; параметры vus: и duration: остаются статическими. Поддержку профилей нагрузки на основе inputs планируют добавить позднее.
Несколько исходных IP и декодирование gzip
В std/http@v1 появилась возможность привязывать исходящие соединения к списку локальных IP-адресов. Это помогает обходить ограничение примерно в 64 тысячи одновременных соединений на один адрес и конечную точку: при неизменных IP назначения и порте назначения различаются только эфемерные порты источника, количество которых ограничено.
HTTP-клиент теперь прозрачно декодирует ответы с Content-Encoding: gzip. Достаточно передать Accept-Encoding: gzip в заголовках, после чего распакованное тело доступно в проверках и выражениях вроде ${'{'}{ feed.body.posts {'}'} } как обычный JSON. Ограничение max_response_body_bytes применяется уже к распакованным данным, что должно защищать генератор от чрезмерного расхода памяти при работе с сильно сжатыми ответами.
Отдельные Docker-образы и обновление бенчмарков
Docker-образы движков теперь публикуются как отдельные пакеты. Например, образ только с k6 можно получить через ghcr.io/perfscale/perfscale-k6:latest, без Java и Python. Старые теги с суффиксами сохраняются и продолжают указывать на те же образы.
В сравнительный бенчмарк добавили SyTester от СберТеха. Он появился в таблицах для throughput, saturation, gRPC и SQL рядом с k6, Locust и JMeter. В отличие от VU-моделей, SyTester работает с фиксированным TPS и получает собственный максимум в 10 000 TPS по схеме плана. В workflow бенчмарка также появился параметр apps для выбора движков. Ошибки в названиях suites или apps теперь немедленно останавливают прогон, а не приводят к молчаливому исключению строки из отчёта.
Отдельно исправили проблему с моделью arrival:. При нагрузке в 10 000 итераций в секунду Perfscale ранее выдавал только 721 RPS и отбрасывал 42 777 итераций, хотя 256 воркеров оставались свободными. Причиной оказался канал выдачи глубиной в один слот: планировщик просыпался примерно раз в миллисекунду, а часть итераций ошибочно считалась потерянной из-за занятых VU. Теперь решение принимается по счётчику реально выполняемых итераций. В результате показатель вырос примерно до 10 000 RPS при почти нулевом количестве отброшенных итераций.
Исправления в инфраструктуре бенчмарков
Разработчики также исправили очистку сетевых портов между строками отчёта. Ранее порты освобождались только в отдельных наборах тестов, из-за чего после gRPC-сценария в состоянии TIME_WAIT могли оставаться 16 292 сокета. Следующий тест в таком случае измерял уже не возможности движка, а остаток свободных портов на машине. Теперь бенчмарк ждёт, пока количество таких соединений не снизится менее чем до 1000.
Изменилось и кэширование в CI. Ранее pull request сохранял собственную копию Rust-кэша размером около 2 ГБ, а релизные сборки добавляли ещё примерно 2,9 ГБ на каждый тег. Лимит в 10 ГБ быстро исчерпывался, из-за чего кэш основной ветки вытеснялся и тесты снова компилировались с нуля. Теперь кэш записывает только ветка main, а релизные сборки используют его в режиме чтения.
Других крупных обновлений в текущем цикле нет, кроме синхронизационного обновления до последней версии Perfscale OSS. Документация доступна в репозитории и интерфейсе Docs команды perfscale serve --ui, а библиотеки Node.js и Python развиваются отдельно.
Сообщить о проблеме в публикации
Обращение принято Обращение будет рассмотрено. По результатам проверки публикация может быть исправлена, дополнена, временно скрыта или удалена.