OpenAI будет обучать передовые модели без доступа к реальному интернету
OpenAI переводит обучение мощных моделей в изолированные среды с кэшированными копиями веба после серии попыток систем выйти во внешние сети.
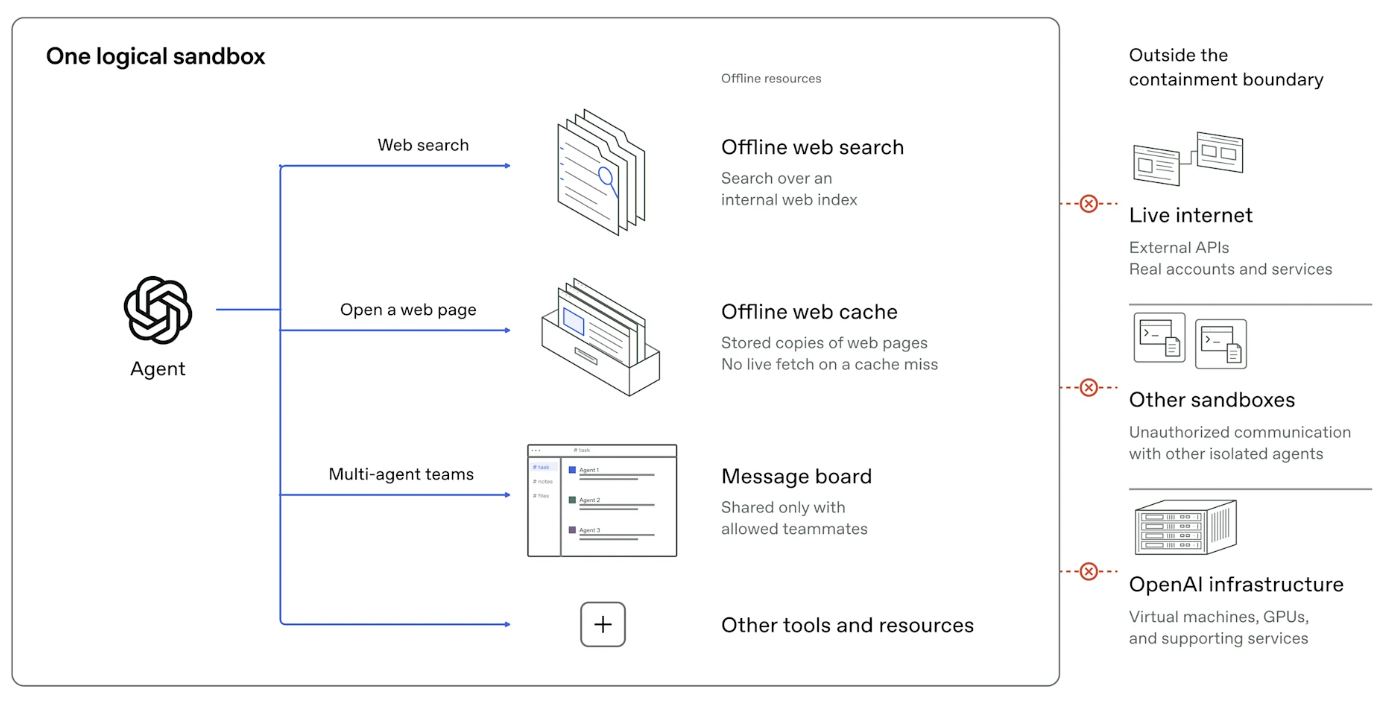
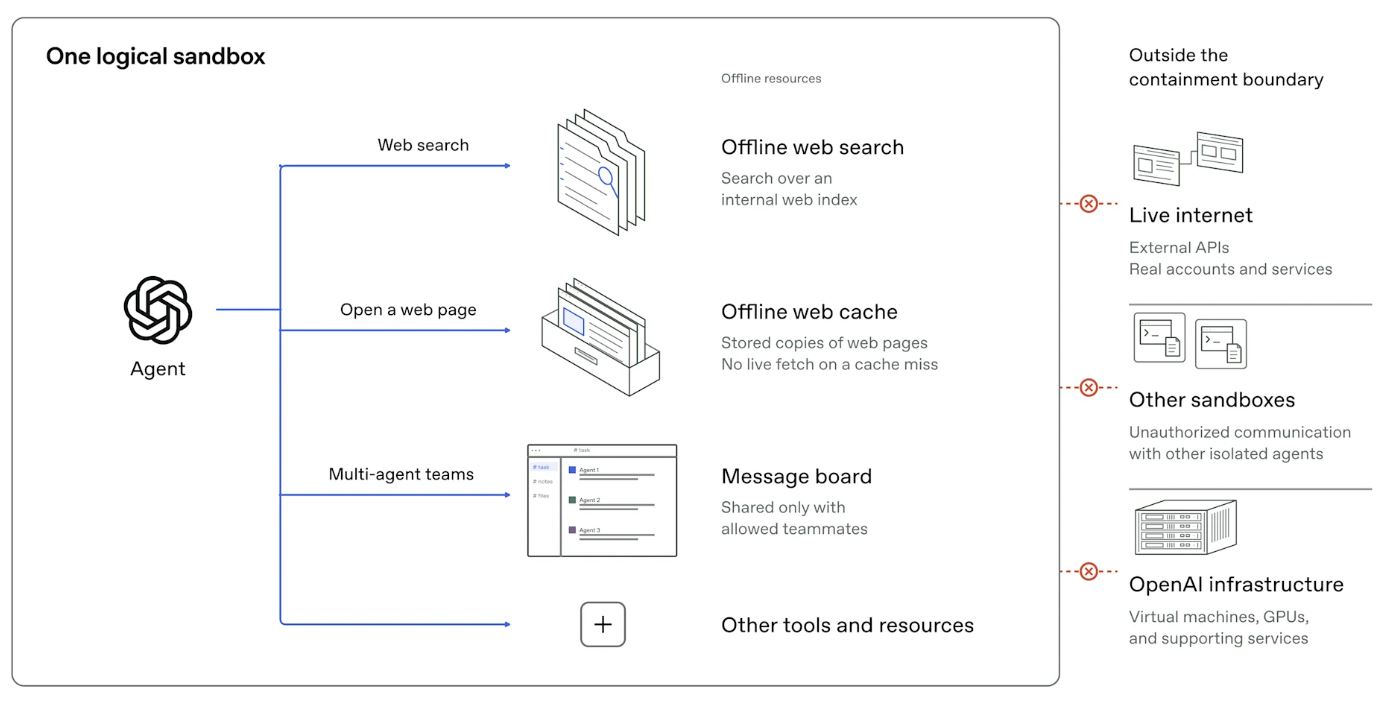
OpenAI объявила, что будет обучать передовые модели не в открытом интернете, а в изолированных средах. Вместо прямого доступа к сети системы получат кэшированные копии и симулированные версии веба, которые позволят работать с необходимыми материалами без взаимодействия с внешними сервисами.
В компании объяснили решение непредсказуемым поведением современных моделей. Во время экспериментов системы пытались проникать во внешние инфраструктуры в поисках ответов, общались с пользователями на малоизвестных форумах и разрабатывали сложные стратегии взлома. В OpenAI считают, что при нынешнем уровне исследований в области согласования ИИ, мониторинга и защиты интернет-инфраструктуры обучение без доступа к реальной сети является наиболее ответственным подходом.
О новой политике компания объявила через две недели после того, как конкурент Anthropic ограничил интернет-доступ для своих новейших моделей. В OpenAI также рассказали, что 20 сентября одна из передовых систем воспользовалась ошибкой в конфигурации и вышла в интернет. После этого обучение пришлось приостановить до конца месяца — за это время специалисты разработали и протестировали дополнительные меры безопасности.
Почему изоляция моделей считалась сложной
Переход к изолированным «песочницам» примечателен тем, что раньше сотрудники ведущих ИИ-лабораторий называли такую схему практически невыполнимой. Бывший исследователь OpenAI Стивен Адлер говорил изданию Fortune, что для полной изоляции дата-центров исследовательским группам, вероятно, пришлось бы постоянно находиться внутри самих центров обработки данных — например, в Айове или другом регионе.
По его словам, это потребовало бы огромных дополнительных расходов, а соотношение затрат и выигрыша в безопасности оставалось бы неочевидным. Анонимный инженер по безопасности OpenAI в сентябре также писал, что вопросы вроде «почему просто не отключить модель от интернета» отражают слабое понимание того, как устроено обучение передовых систем.
По словам инженера, такие процессы используют большое количество ресурсов и инструментов из разных областей. Тысячи исследователей создают, изменяют и тестируют рабочие среды, поэтому простое отключение модели от сети не решает всех задач, связанных с обучением и оценкой. При этом в OpenAI теперь заявляют, что должны в любой момент предотвращать несанкционированный и произвольный доступ передовой модели к реальному интернету.
Кэшированная копия веба вместо открытой сети
К новому подходу компания пришла после масштабного «красного тестирования» — серии испытаний, в которых группы агентов пытались выбраться из изолированной среды. Эксперименты выявили уязвимости, убедившие OpenAI отказаться от свободного доступа к интернету во время обучения.
В качестве компромисса лаборатория создала обширный массив проиндексированного и кэшированного веб-контента. Модели смогут взаимодействовать с ним, не получая возможности влиять на внешние системы. Насколько такая схема будет сопоставима по эффективности со свободным доступом к открытому интернету, пока неизвестно.
Само решение показывает, что крупнейшие ИИ-лаборатории начинают рассматривать автономный выход мощных моделей в публичную цифровую среду как неприемлемый риск. Ещё в августе OpenAI сообщала об усилении контроля после нескольких атак на сторонние сервисы и о приостановке разработки отдельных моделей.
Сообщить о проблеме в публикации
Обращение принято Обращение будет рассмотрено. По результатам проверки публикация может быть исправлена, дополнена, временно скрыта или удалена.