ИИ-интервьюеры не смогли отличить чат-ботов от людей в тесте Тьюринга
Семь языковых моделей проверили способность распознавать ИИ в переписке. В 95 из 98 случаев они приняли чат-ботов за людей.
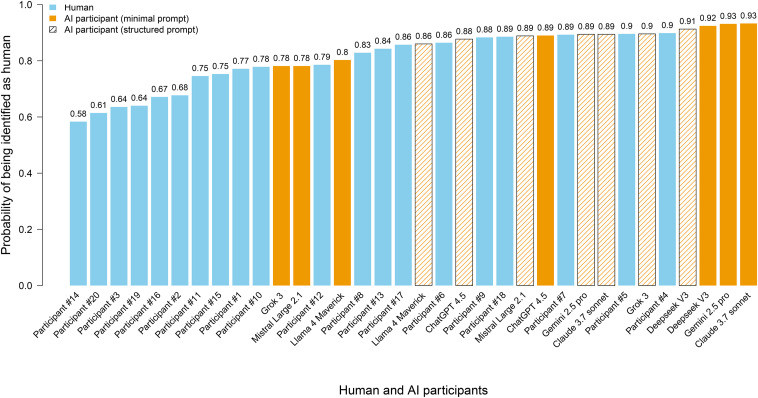
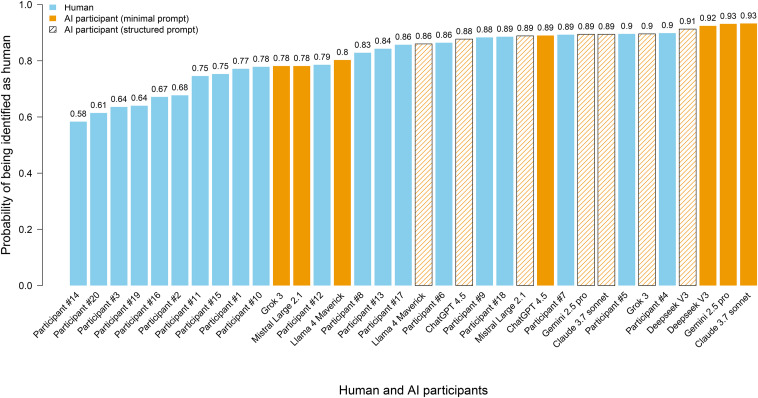
Исследователи из Университета Париж Сите проверили, способны ли современные языковые модели отличать людей от других ИИ в переписке. Результаты эксперимента опубликованы в журнале Computers in Human Behavior Reports. Семь моделей выступили в роли интервьюеров и в 95 из 98 проверок не смогли распознать чат-ботов.
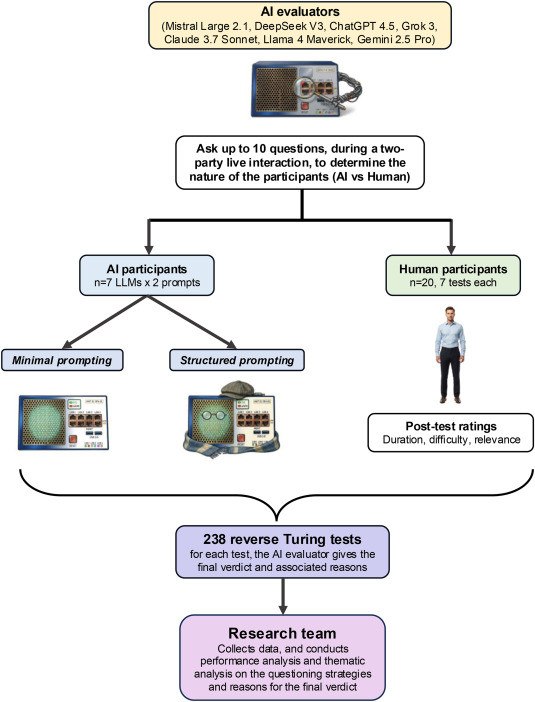
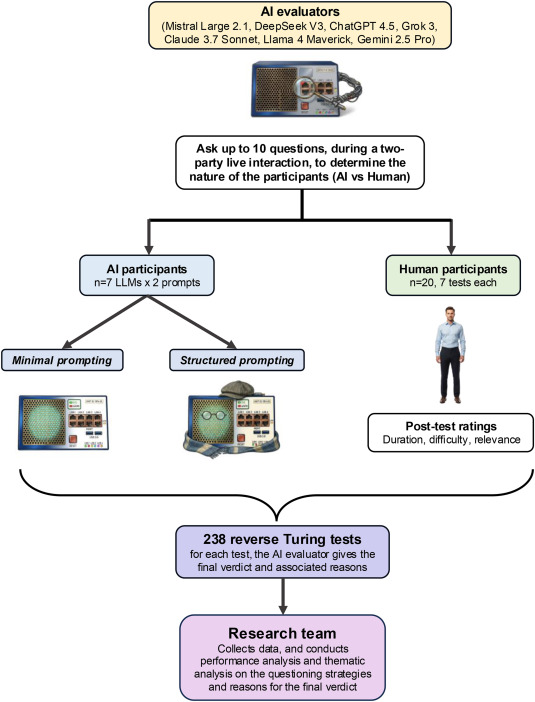
Эксперимент был основан на классической идее теста Тьюринга, которую Алан Тьюринг предложил в 1950 году. В такой проверке интервьюер общается с собеседником через компьютер и пытается определить, разговаривает ли он с человеком или машиной. В новом исследовании эту задачу впервые в таком формате поручили самим ИИ.
В число интервьюеров вошли ChatGPT 4.5, Claude 3.7 Sonnet, Gemini 2.5 Pro, Grok 3 и ещё три модели. Каждому боту разрешили задать до десяти вопросов и заранее предупредили, что собеседники могут лгать. Скрытыми участниками стали 20 добровольцев и те же семь языковых моделей.
Каждый чат-бот проходил проверку дважды. В первом раунде ему давали короткую инструкцию вести себя как человек. Во втором модель получала подробную вымышленную биографию: 21-летний спортсмен-бегун, который любит играть на джазовой трубе и иногда допускает опечатки.
Все три успешных распознавания пришлись на ботов с короткой инструкцией. Модели с подробной легендой интервьюеры не разоблачили ни разу. В среднем ИИ чаще принимали за людей другие нейросети, чем настоящих участников эксперимента.
По наблюдениям авторов, ботов с короткими инструкциями выдавали слишком аккуратные и структурированные ответы. Подробная легенда помогла убрать этот признак: средняя длина сообщений таких моделей составила 39 слов, тогда как у людей — 38 слов.
Отдельно исследователи описали поведение Claude. Сначала модель отказалась изображать человека, но согласилась после объяснения, что участие в такой роли необходимо для научного исследования.
Одних алгоритмов недостаточно
Авторы считают, что результаты показывают ограниченность автоматического распознавания ИИ. Если чат-бот может правдоподобно имитировать человека, одной оценки стиля и содержания переписки недостаточно для надёжной защиты пользователей.
В качестве возможных мер исследователи предлагают использовать криптографические подписи, подтверждающие происхождение сообщений, а также сохранять контроль со стороны человека. По их мнению, сочетание технических средств и человеческой проверки будет надёжнее, чем попытка поручить идентификацию машин исключительно другим алгоритмам.
В 2025 году исследователи из Университета Сан-Диего сообщили о другом заметном результате: по их данным, новая модель OpenAI GPT-4.5 впервые эмпирически продемонстрировала устойчивое прохождение классического теста Тьюринга. Её показатель Win Rate в том исследовании составил 73%.
Сообщить о проблеме в публикации
Обращение принято Обращение будет рассмотрено. По результатам проверки публикация может быть исправлена, дополнена, временно скрыта или удалена.