Perfscale перевёл метрики на шардинг и увеличил пропускную способность записи
В новом OSS-релизе Perfscale переработали метрики, обновили serve, CI и self-update, добавили очистку кэша и начали точечную сборку модулей.
Новый выпуск Perfscale целиком посвящён изменениям в открытой части проекта. Авторы отмечают, что почти все обновления на этот раз связаны с метриками, а выпуск тестов и изменений ограничен из-за исчерпания доступных минут GitHub Actions: сейчас используется около 90% лимита.
Шардированные метрики ускорили запись
Главным изменением стала переработка структуры хранения метрик. Вместо единого объекта Arc<Mutex<Metrics>> теперь используется шардированная структура ShardedMetrics — вектор из нескольких mutex-блокировок. Благодаря этому потоки меньше конкурируют за общий ресурс и могут работать параллельно.
На тесте с 16 потоками пропускная способность записи выросла с 14,7 млн до 118,6 млн операций в секунду. При этом разработчики предупреждают, что итоговые показатели зависят не только от Perfscale: ограничением могут стать системные значения ulimit и доступное количество сокетов в операционной системе.
Обновления serve и проверка SQL-сценариев
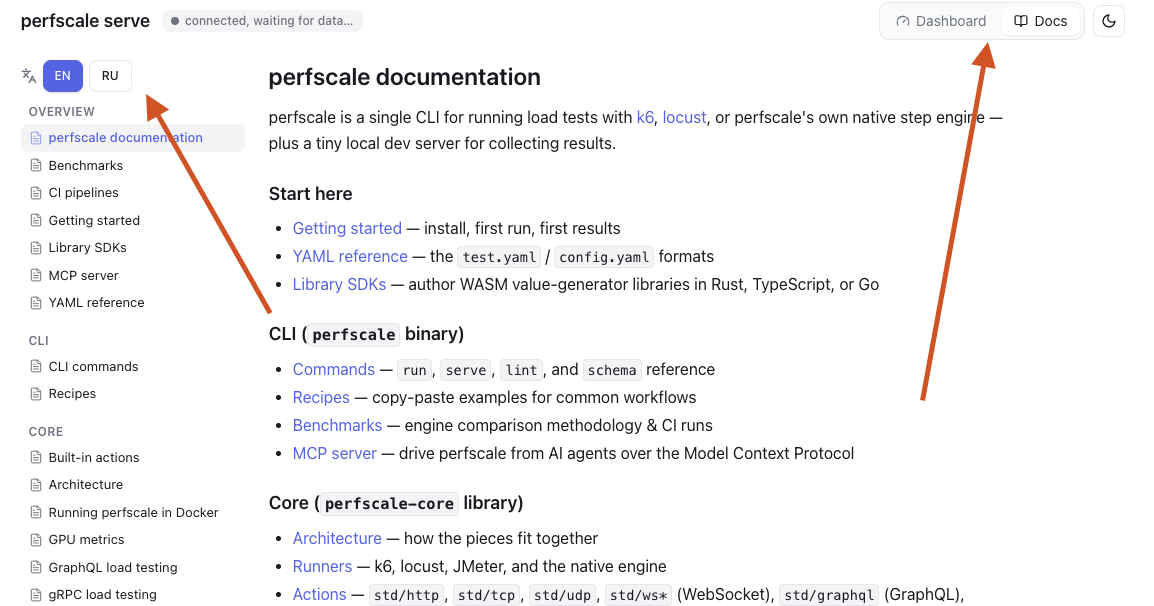
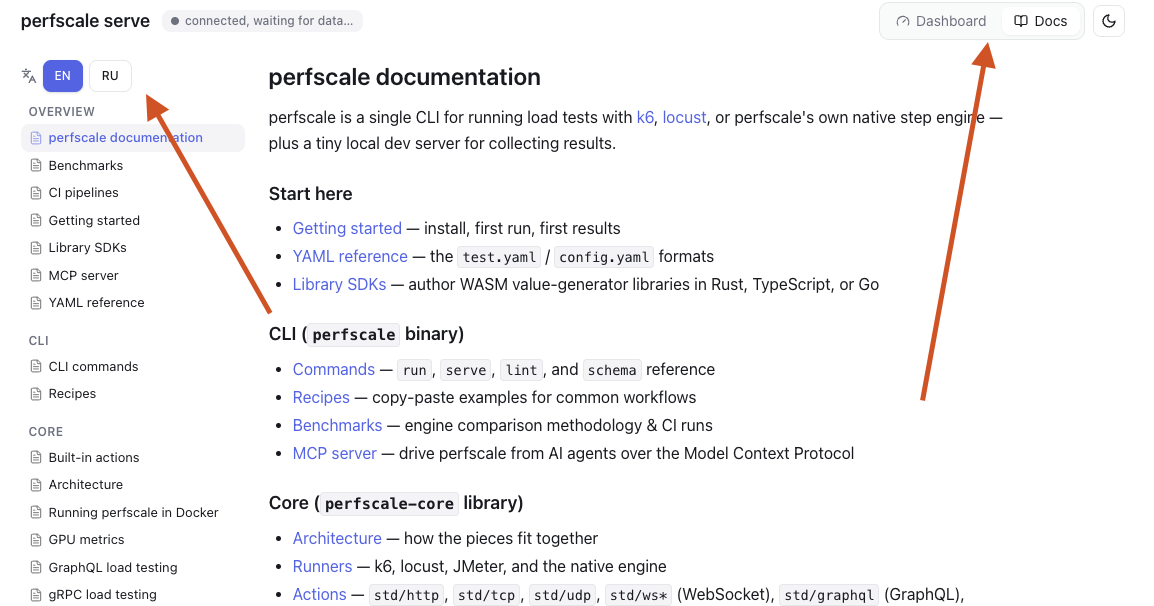
Команду serve и сервер постепенно расширяют. При запуске serve и открытии интерфейса в браузере теперь доступна документация на двух языках. Те же версии документации опубликованы в разделах для английского и русского языков.
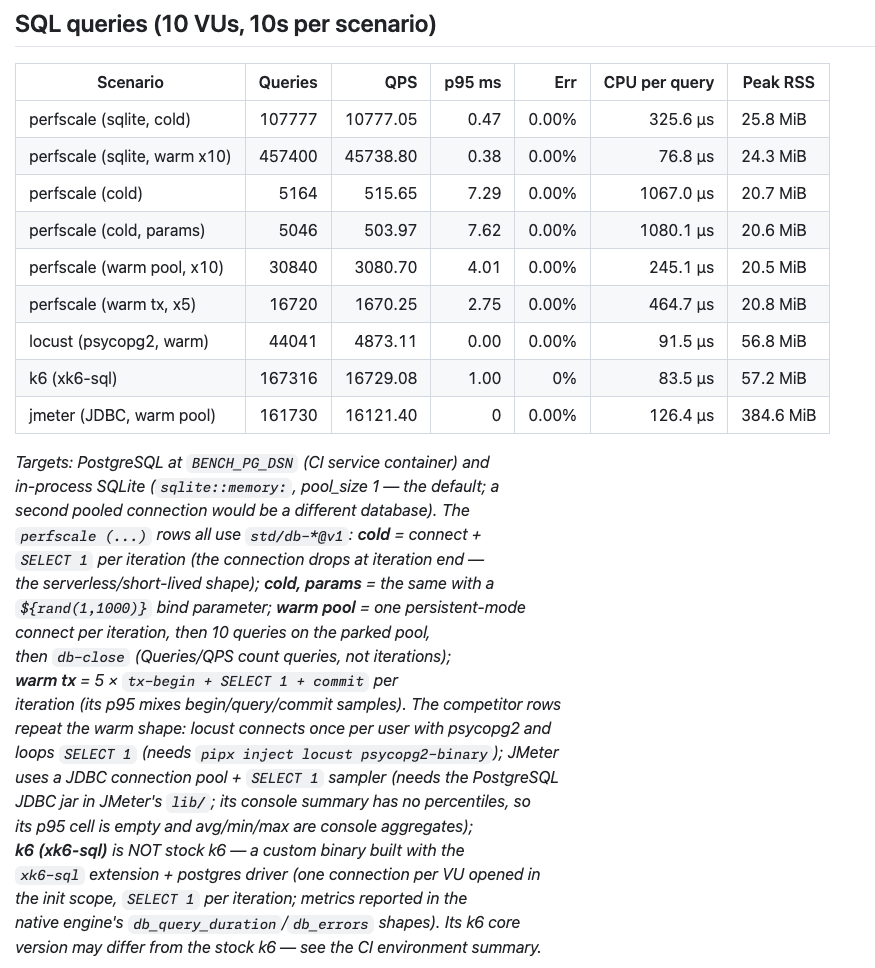
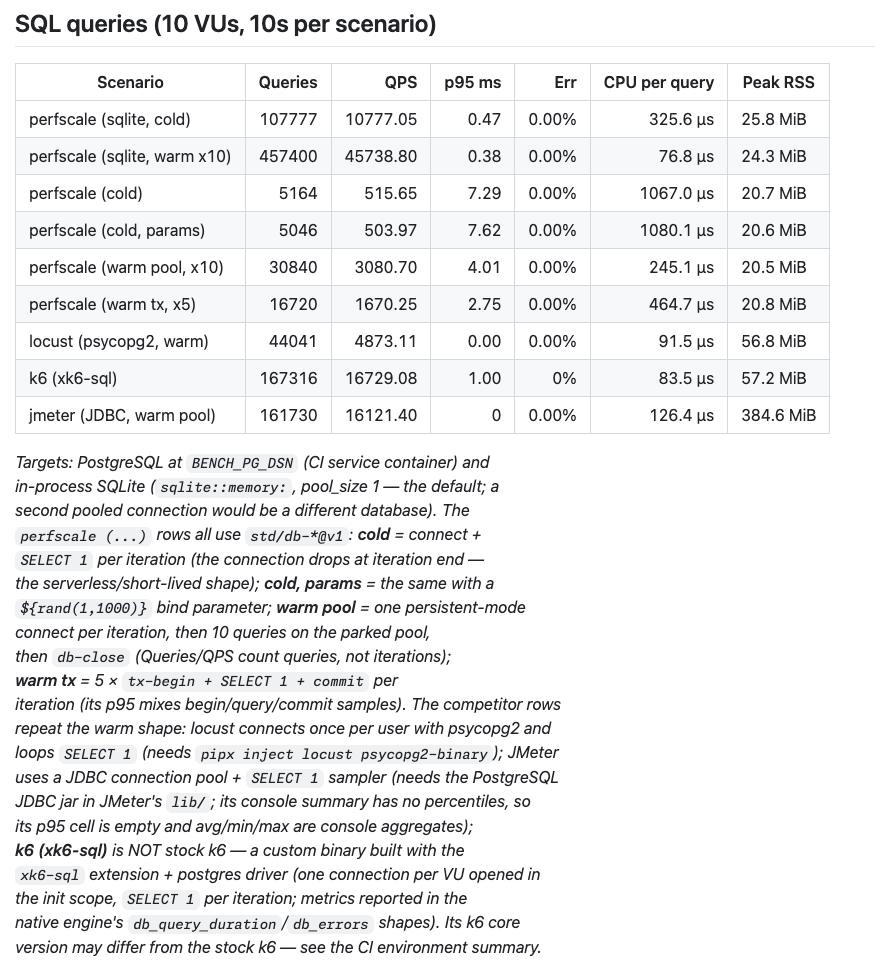
В проекте также обновили ежедневный bench-профиль, который сравнивает Perfscale с Locust, k6 и JMeter в разных сценариях и помогает отслеживать утечки. После появления поддержки SQL в тестах обнаружилось, что для k6 не хватало соответствующих замеров. Теперь в сравнении используется не стандартный k6, а кастомная сборка xk6-sql с драйвером PostgreSQL.
В сценариях проверяются PostgreSQL через переменную BENCH_PG_DSN и встроенный SQLite в памяти с размером пула 1. Для Perfscale сравниваются холодные подключения с запросом SELECT 1, варианты с параметрами, постоянный пул соединений и транзакционные операции. Locust работает через psycopg2, JMeter — через JDBC-пул, а xk6-sql использует одно соединение на виртуального пользователя и выполняет запрос на каждой итерации. Для JMeter в консольном отчёте отсутствуют перцентили, поэтому значение p95 для него не выводится.
Кэш, обновления и проверки зависимостей
В командной строке появилась команда perfscale cache clean для удаления кэша скачанных модулей. Механизм self-update стал интерактивным и получил повторные попытки для медленных сетей. При необходимости автоматическое выполнение можно включить флагом --non-interactive.
Dev-сборки теперь маркируются версиями формата 0.25.0-next.N+g. По выводу команды --version можно сразу определить, что используется промежуточная сборка, а не официальный релиз.
Для CI усилили проверку контрольных сумм и добавили SHA-пины в GitHub Actions, GitLab CI и Helm-чарты. Если раньше несоответствие вызывало предупреждение, теперь такая проверка приводит к ошибке и останавливает сборку.
sdk-js архивирован, модули будут собираться точнее
Репозиторий sdk-js заархивировали: он больше не использовался, а расширения перенесли в sdk-libraries и WASM-модули.
Отдельное направление работы связано с размером бинарных файлов. В Perfscale накопилось много pro-модулей, включая SOAP, FIX, LLM, Pub/Sub и SQL, однако конкретному пользователю обычно нужна только часть возможностей. Поэтому разработчики начали переходить к точечному запеканию модулей: если сценарий использует только pro/sql, в бинарник не потребуется включать SOAP, FIX и остальные расширения.
Такой подход должен уменьшить размер итогового бинарника, но переносит часть работы на запуск — нужные модули будут запекаться непосредственно перед выполнением сценария. Авторы отмечают, что практические преимущества и возможные недостатки этой схемы покажет дальнейшее использование.
Сообщить о проблеме в публикации
Обращение принято Обращение будет рассмотрено. По результатам проверки публикация может быть исправлена, дополнена, временно скрыта или удалена.
Читайте новые материалы журнала — свежие сюжеты каждый день.
На главную