Liquid AI выпустила семейство LFM3 с открытыми весами
Liquid AI представила шесть моделей LFM3 примерно на 2 млрд параметров. Их сильная сторона — агентные сценарии, вызов инструментов и экономичный инференс.
Liquid AI, стартап исследователей MIT, открыла веса семейства LFM3. В первый релиз вошли шесть моделей примерно на 2 млрд параметров: текстовая LFM3-1.7B, визуальная LFM3-VL-2B, голосовая LFM3-Audio-2B, омнимодальная LFM3-Omni-2B, а также две decision-модели — d1-2B и d1-Omni-2B.
Все варианты используют общий бэкбон LFM3-1.7B-Base, который обучали на 22 трлн токенов. При этом семейство рассчитано не столько на универсальное сложное рассуждение, сколько на локальный запуск, работу с инструментами и агентные сценарии.
Гибридная архитектура вместо полного трансформера
В отличие от обычного трансформера, где каждый слой сопоставляет текущий токен со всеми предыдущими, LFM3 сочетает несколько типов обработки. Из 24 слоёв только шесть используют полноценное внимание и работают со всем доступным контекстом. Ещё пять слоёв анализируют окно из 256 последних токенов, а 13 применяют короткие свёртки, учитывающие сам токен и шестерых соседей.
Такой подход уменьшает объём KV-кэша примерно до 27% от показателя обычной трансформерной модели сопоставимого размера. Это особенно важно при длинном контексте: именно KV-кэш заметно увеличивает требования к видеопамяти по мере роста последовательности.
Соотношение типов слоёв Liquid AI подбирала автоматическим поиском с замерами на 14 сочетаниях устройств и программных бэкендов. После отдельного этапа дообучения на 3,5 трлн токенов модель получила контекст длиной до 256 тысяч токенов.
Сильные и слабые стороны по тестам
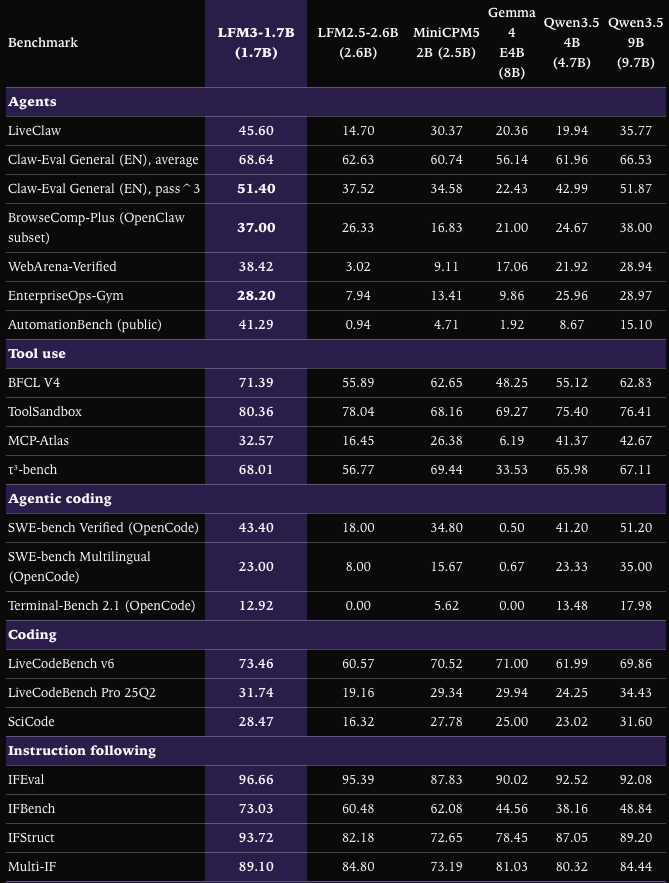
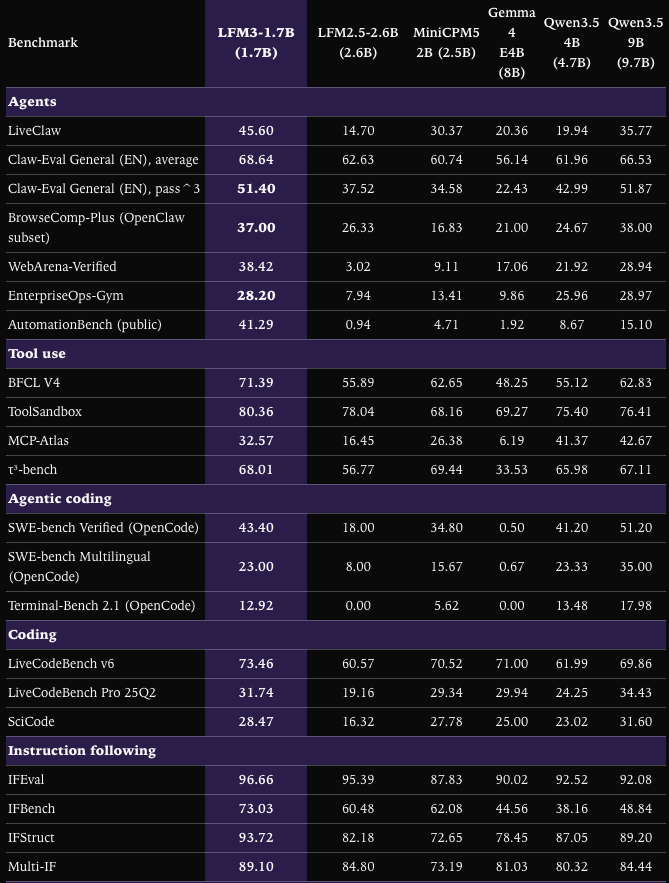
По данным Liquid AI, LFM3-1.7B хорошо показывает себя в задачах, связанных с инструментами и соблюдением формата. На BFCL V4 для оценки вызова функций модель набрала 71,4 балла против 62,8 у Qwen3.5 9B. В WebArena-Verified, где агент выполняет задачи в браузере, результат составил 38,4 балла против 28,9 у Qwen3.5 9B. На IFEval показатель достиг 96,7.
В задачах, требующих широких знаний и сложного рассуждения, преимущество оказалось на стороне более крупной модели. На GPQA Diamond LFM3-1.7B получила 63,4 балла против 80,4 у Qwen3.5 9B, а на SWE-bench Verified — 43,4 против 51,2. Это указывает на специализацию LFM3: модель умеет следовать инструкциям и вызывать внешние инструменты, но небольшой объём параметров ограничивает её энциклопедические и аналитические способности.
Все приведённые результаты опубликованы самой Liquid AI. На момент выхода независимых воспроизведений этих измерений не было.
Мультимодальные версии и запуск
Визуальная LFM3-VL-2B в среднем набрала 71,4 балла в 62 тестах на понимание изображений. Это близко к результату Gemma 4 12B, у которой 71,7 балла, и выше показателя Qwen 3.5 2B — 64,0. Собственный визуальный энкодер модели содержит 164 млн параметров.
Голосовая версия выглядит менее убедительно в сравнении по английской речи: её показатель WER составляет 6,2 против 5,5 у Voxtral Mini. Для оценки качества распознавания меньший WER означает лучший результат.
Порог для локального запуска у LFM3 низкий. В четырёхбитной квантизации текстовая модель занимает около 1 ГБ. В документации указана работа через Transformers, vLLM и SGLang с OpenAI-совместимым API. Также доступны Docker Model Runner и готовые варианты для llama.cpp, Ollama и LM Studio. Liquid AI заявляет поддержку MLX и NPU Qualcomm.
Дообучение возможно на одной видеокарте. Компания опубликовала около десяти ноутбуков для сценариев SFT, DPO и GRPO. На одном ускорителе B300 при 1024 параллельных запросах LFM3-1.7B, по данным разработчиков, обрабатывает 3,6 млрд токенов в сутки — примерно 42 тысячи токенов в секунду.
Для каких задач подходит модель
Такие характеристики делают LFM3 интересной для массовых прикладных задач: классификации тикетов, извлечения полей из документов, маршрутизации запросов между агентами и других операций, где важны скорость, предсказуемый формат ответа и невысокая стоимость инференса.
При этом у семейства есть существенное ограничение по лицензии. Модели распространяются по LFM Open License v1.0. Согласно опубликованным условиям, компаниям с годовой выручкой более 10 млн долларов требуется отдельное коммерческое соглашение. Для крупных российских интеграторов и банков это может означать необходимость согласовать использование моделей с Liquid AI до запуска коммерческого проекта.
LFM3 занимает промежуточную нишу между облачными API и более тяжёлыми локальными моделями. Если агент в основном вызывает инструменты и работает по строгой схеме, LFM3-1.7B имеет смысл проверить на собственных данных. Для задач, где требуется глубокое знание предметной области или сложное рассуждение, более крупные модели пока выглядят надёжнее.
Сообщить о проблеме в публикации
Обращение принято Обращение будет рассмотрено. По результатам проверки публикация может быть исправлена, дополнена, временно скрыта или удалена.