Google: robots.txt не запрещает ИИ использовать контент для обучения
Гари Ильес из Google объяснил, почему директива Disallow управляет обходом страниц, но не гарантирует запрет на использование материалов в датасетах ИИ.
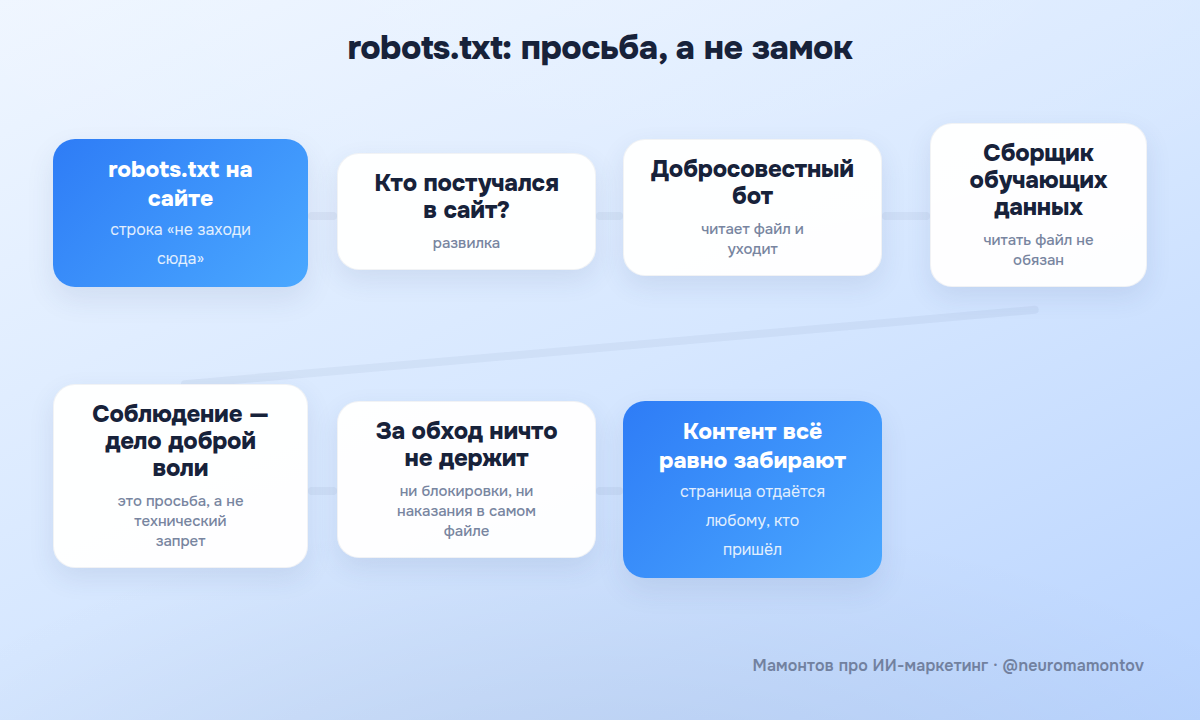
Последние два года у владельцев сайтов сложилась коллективная привычка: дописать в robots.txt Disallow для GPTBot, CCBot и прочих AI-краулеров — и считать, что контент от ИИ закрыт. Гари Ильес из Google провёл границу, которая эту привычку обнуляет: robots.txt управляет краулингом, а не использованием контента для обучения (Search Engine Journal, 2026).
Ильес разделил две вещи, которые многие паблишеры считали синонимами.
Первое — robots.txt. Это протокол доступа для краулеров, и он отвечает на один вопрос: может ли бот зайти на страницу и прочитать её содержимое. Это всё, для чего он предназначен. Файл появился задолго до генеративного ИИ — он про дисциплину обхода, а не про судьбу уже прочитанного текста.
Второе — использование контента для обучения моделей. Это отдельный процесс, и регулируется он другими механизмами: политиками конкретных компаний, opt-out-программами и, в конечном счёте, авторским правом. Блокировка AI-краулера через robots.txt не означает, что контент не окажется в датасете: его могли собрать раньше, другим путём или в рамках другой программы. Директива Disallow просто не отвечает на вопрос, куда попадёт уже собранный контент.
По сути Ильес сказал: вы решаете задачу краулинга, думая, что решаете задачу защиты от обучения. Это два разных процесса с двумя разными точками контроля — и смешивать их означало строить стену в одном месте, пока все ходят через другое.
Тут всё упирается в природу самого файла. robots.txt — это вежливая просьба, а не технический барьер. Воспитанный краулер её прочитает и уйдёт. А тот, кто пришёл именно за обучающими данными, ту же строчку прочитает — и спокойно пойдёт дальше, потому что физически запретить ему файл ничего не может. Отсюда и ложное чувство безопасности у тех, кто два года выстраивал "защиту контента" именно на этой директиве. Причём безопасности, официально подтверждённой самим Google.
Важная оговорка, чтобы не впадать в другую крайность: robots.txt никто не отменял и не сломал. Для своей задачи — управления обходом — он работает ровно так же, как работал. Меняется не он, а понимание того, какую задачу он закрывает, а какую нет.
Дальше начинается часть, которая интереснее технической. Вся стратегия "спрячемся от ИИ одной строчкой" держалась на допущении, что ценность — в самом факте наличия текста. Но ценность не там.
В нейровыдаче модель всё равно соберёт десяток источников и выдаст один ответ. И попадёт в этот ответ не тот, кто громче закрылся, а тот, у кого есть что сказать по сути. ИИ отсеивает тех, кому нечего предъявить. Это и есть смена точки зрения: защита смещается с вопроса "как запретить" на вопрос "как сделать так, чтобы без меня ответ получался неполным".
Работа от этого становится другой. Не прятать фактуру, а наращивать её — экспертизу, цифры, опыт, то, что нельзя пересказать трижды пересказанным текстом. Про этот сдвиг от "закрыться" к "быть незаменимым источником" я подробно раскладывал в дневнике — как устроено продвижение в нейросетях, читается как прямое продолжение этого разбора.
И ещё одно наблюдение, которое эта новость хорошо иллюстрирует. Спрос на видимость в нейросетях появился не потому, что кто-то его придумал и навязал. Он появился потому, что люди пошли задавать вопросы моделям вместо поисковой строки. Маркетинг идёт за потребностью, а не создаёт её — и защита контента, и способы продвижения перестраиваются следом за тем, как меняется само поведение.
Если ваша защита контента от ИИ держалась на одной директиве в robots.txt — её, по сути, не было. Оставьте файл для краулинга, по прямому назначению. А настоящую задачу решайте отдельно: стать тем источником, мимо которого модель не пройдёт.
Сообщить о проблеме в публикации
Обращение принято Обращение будет рассмотрено. По результатам проверки публикация может быть исправлена, дополнена, временно скрыта или удалена.