DeepSeek и Moonshot могли использовать ответы GPT-6 Astra для обучения своих моделей
По данным The Information, китайские лаборатории применяли дистилляцию ответов OpenAI на фоне усиления защиты Claude от массового сбора данных.
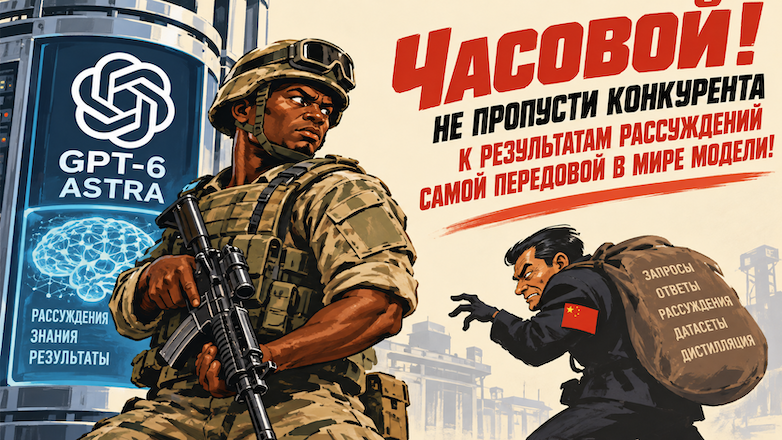
Китайские компании DeepSeek и Moonshot AI могли использовать ответы модели GPT-6 Astra от OpenAI для обучения собственных систем. Об этом пишет The Information со ссылкой на источники, знакомые с ситуацией. Представители Moonshot AI не стали комментировать публикацию, а DeepSeek не ответила на запрос журналистов.
По данным издания, Moonshot применяла результаты Astra при разработке Kimi K3.1 Pro, выпущенной 23 октября. Об этом рассказали три источника. Ещё два собеседника сообщили, что ответы той же модели использовались при создании DeepSeek V4.1-Flash 1017 — обновления, представленного 17 октября. Каким именно способом компании получали доступ к ответам и на каких этапах обучения применяли собранные данные, неизвестно.
Как работает дистилляция
Речь идёт о дистилляции — распространённом методе, при котором ответы более мощной модели используются как обучающие примеры для другой системы. Наибольшую ценность представляют не только готовые решения, но и подробные объяснения, демонстрирующие ход рассуждений и способы решения задач.
Такой подход позволяет частично переложить расходы на подготовку данных на чужую инфраструктуру. Более сильная модель генерирует решения, объяснения и примеры, после чего на их основе обучается собственная система. Для китайских лабораторий этот метод особенно важен из-за ограниченного доступа к современным американским ускорителям: он помогает сокращать сроки и стоимость разработки, а итоговая модель может работать на собственной инфраструктуре без постоянной зависимости от исходного API.
Сама по себе дистилляция не является незаконной. Однако OpenAI и Anthropic считают проблемой использование их сервисов для создания конкурирующих моделей в обход условий доступа и технических ограничений. Американские компании несут основные расходы на разработку передовых систем, тогда как конкуренты могут использовать результаты этих инвестиций для выпуска более дешёвых альтернатив.
Почему лаборатории переключились с Claude на Astra
Ранее основным источником данных для подобных схем, по данным The Information, были модели Claude. Но после усиления защиты Anthropic китайские разработчики, как предполагается, начали чаще обращаться к сервисам OpenAI.
23 февраля Anthropic обвинила DeepSeek, Moonshot AI и MiniMax в массовой дистилляции Claude. По оценке компании, лаборатории провели более 16 миллионов чатов примерно через 24 тысячи поддельных аккаунтов. Посредники распределяли запросы между множеством учётных записей и пытались получать не только обычные ответы, но и скрытые рассуждения моделей.
В сентябре Anthropic подробно описала такие схемы, а 12 октября сообщила о результатах усиления защиты. По оценке компании, объём извлекаемых злоумышленниками токенов скрытых рассуждений сократился на 90–99%. Именно эти меры, по сведениям The Information, могли стать одной из причин перехода к Astra.
При этом OpenAI столкнулась с похожей активностью ещё до появления Astra. 30 сентября компания рассказала о кампании, начавшейся в июле, и связала часть обнаруженной активности с людьми, имеющими отношение к Moonshot AI. В одном из эпизодов 24–25 июля OpenAI зафиксировала 16 тысяч подозрительных запросов от более чем четырёх тысяч пользователей. Позднее расследование выявило связанные шаблоны запросов у более чем 15 тысяч пользователей. К 28 июля компания заявила о пресечении кампании.
Участники этих операций пытались извлекать защищённые рассуждения моделей, в том числе переносили зашифрованные блоки между диалогами и просили систему восстановить их содержимое. Июльская кампания не могла быть направлена на Astra: модель появилась только в сентябре. Однако этот эпизод показывает, что попытки получать внутренние данные моделей предпринимались задолго до нынешних сообщений.
Какие меры применяет OpenAI
OpenAI использует несколько уровней защиты от промышленного сбора данных. Компания анализирует масштаб и разнообразие запросов, выявляет характерные шаблоны оценки и ранжирования ответов, отслеживает попытки извлечения скрытых рассуждений и ищет связи между аккаунтами. Подозрительным пользователям и связанным с ними учётным записям могут ограничить или полностью закрыть доступ.
В сентябре OpenAI сообщила о дополнительных мерах: усилении контроля при регистрации, защите зашифрованных рассуждений от переноса между аккаунтами и организациями, а также проверке потокового вывода, который потенциально способен раскрыть внутренние данные модели.
12 февраля компания направила специальному комитету Палаты представителей США девятистраничный документ, посвящённый борьбе с несанкционированной дистилляцией. Кроме технических механизмов, OpenAI обновляет юридические ограничения. Редакция правил, которая должна вступить в силу 20 ноября, отдельно запрещает использовать модели компании для генерации обучающих данных, оценки и ранжирования ответов, фильтрации и подготовки наборов для обучения с подкреплением конкурирующих систем.
Однако условия пользовательского соглашения сами по себе не мешают собирать данные через тысячи аккаунтов. Поэтому OpenAI планирует распространить требования безопасности и на сторонние площадки, через которые предоставляется доступ к её моделям. Маршрутизаторам моделей и API-шлюзам потребуется согласование с компанией, а партнёры должны будут участвовать в выявлении и пресечении нарушений.
Кроме того, OpenAI разрабатывает механизм SafetyIDs. Он должен позволить различать конечных пользователей внутри сторонних приложений, не раскрывая их личности самой OpenAI. Предполагается, что это поможет блокировать нарушителей точнее и не отключать целые организации из-за действий отдельных пользователей.
Цена усиления защиты
Для обнаружения массовой дистилляции разработчикам приходится анализировать не только содержание запросов, но и поведение пользователей: частоту обращений, повторяющиеся шаблоны, связи между аккаунтами и способы использования ответов. Это создаёт риск ошибочных ограничений для добросовестных клиентов.
Anthropic признаёт, что её новые механизмы уже затронули часть обычных пользователей. Некоторым разработчикам пришлось менять API-интеграции после ограничения возможностей редактирования контекста с сохранёнными рассуждениями. По данным компании, классификатор ошибочно блокирует менее 0,1% добросовестных запросов. С 24 сентября в отдельных категориях, включая попытки извлечения рассуждений, Anthropic также взимает плату за запросы, отклонённые системой защиты ещё до генерации ответа.
Это не означает, что OpenAI применяет или обязательно будет применять идентичные ограничения. Компания не раскрывает сопоставимую статистику ошибочных блокировок. Но конфликт интересов остаётся очевидным: чем строже защита, тем сложнее отличать промышленный сбор обучающих данных от нормальной работы разработчиков, исследователей и пользователей API.
Anthropic признаёт, что борьба с дистилляцией ещё далека от завершения. Даже если полностью закрыть доступ к скрытым рассуждениям, обычные ответы передовых моделей всё равно останутся ценным обучающим материалом. Крупнейшим лабораториям приходится выбирать между открытой продажей доступа к мощным системам и риском помочь потенциальным конкурентам, а любые технические барьеры неизбежно могут затронуть не только нарушителей, но и обычных пользователей.
Сообщить о проблеме в публикации
Обращение принято Обращение будет рассмотрено. По результатам проверки публикация может быть исправлена, дополнена, временно скрыта или удалена.