Perplexity и NVIDIA предложили JOLT для более эффективного обучения языковых моделей
Метод JOLT объединяет самодистилляцию и обучение с подкреплением. Авторы заявляют о заметном снижении затрат на обучение и росте качества на агентных задачах.
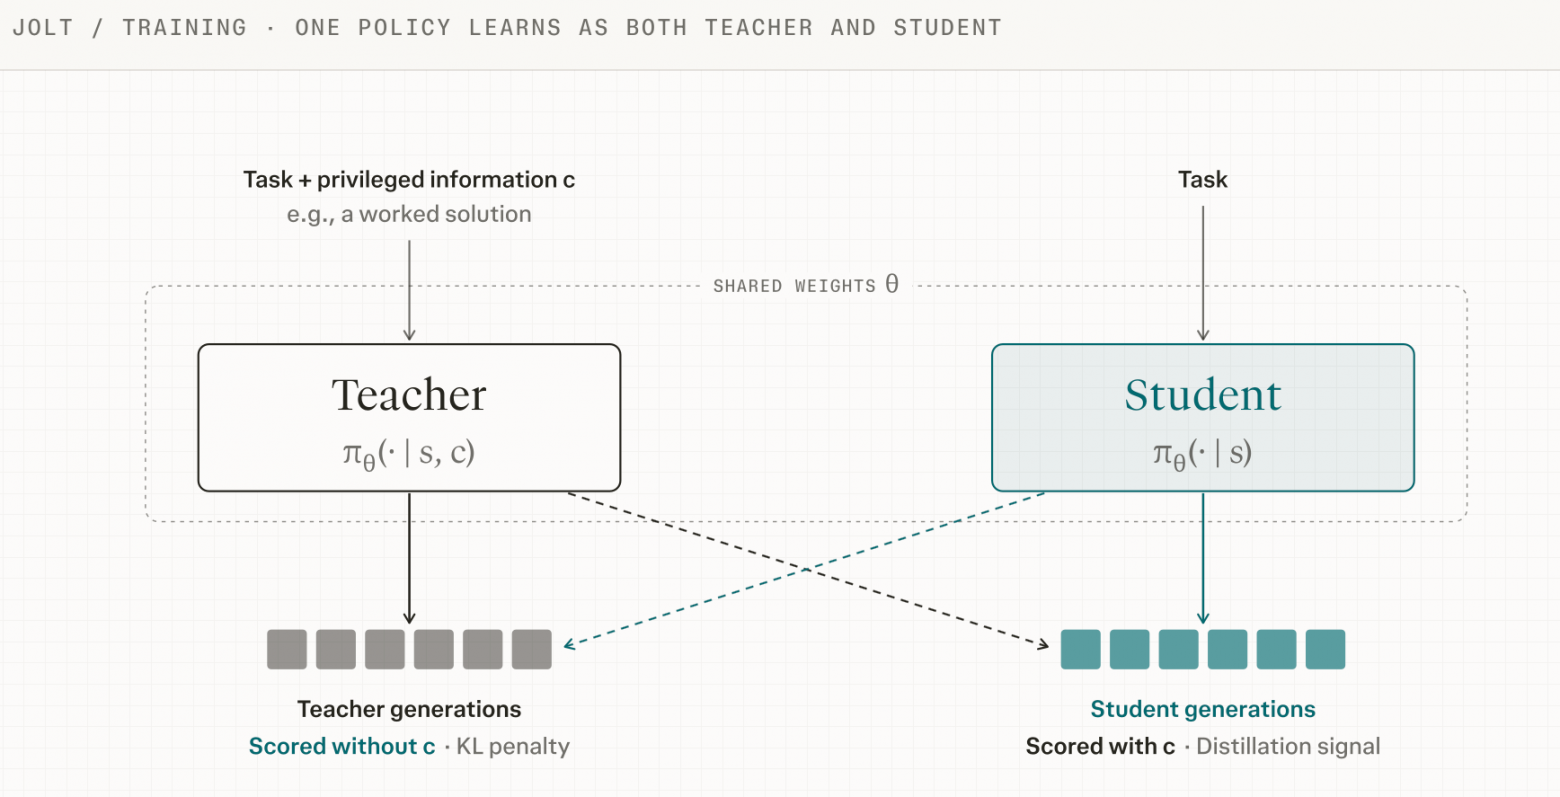
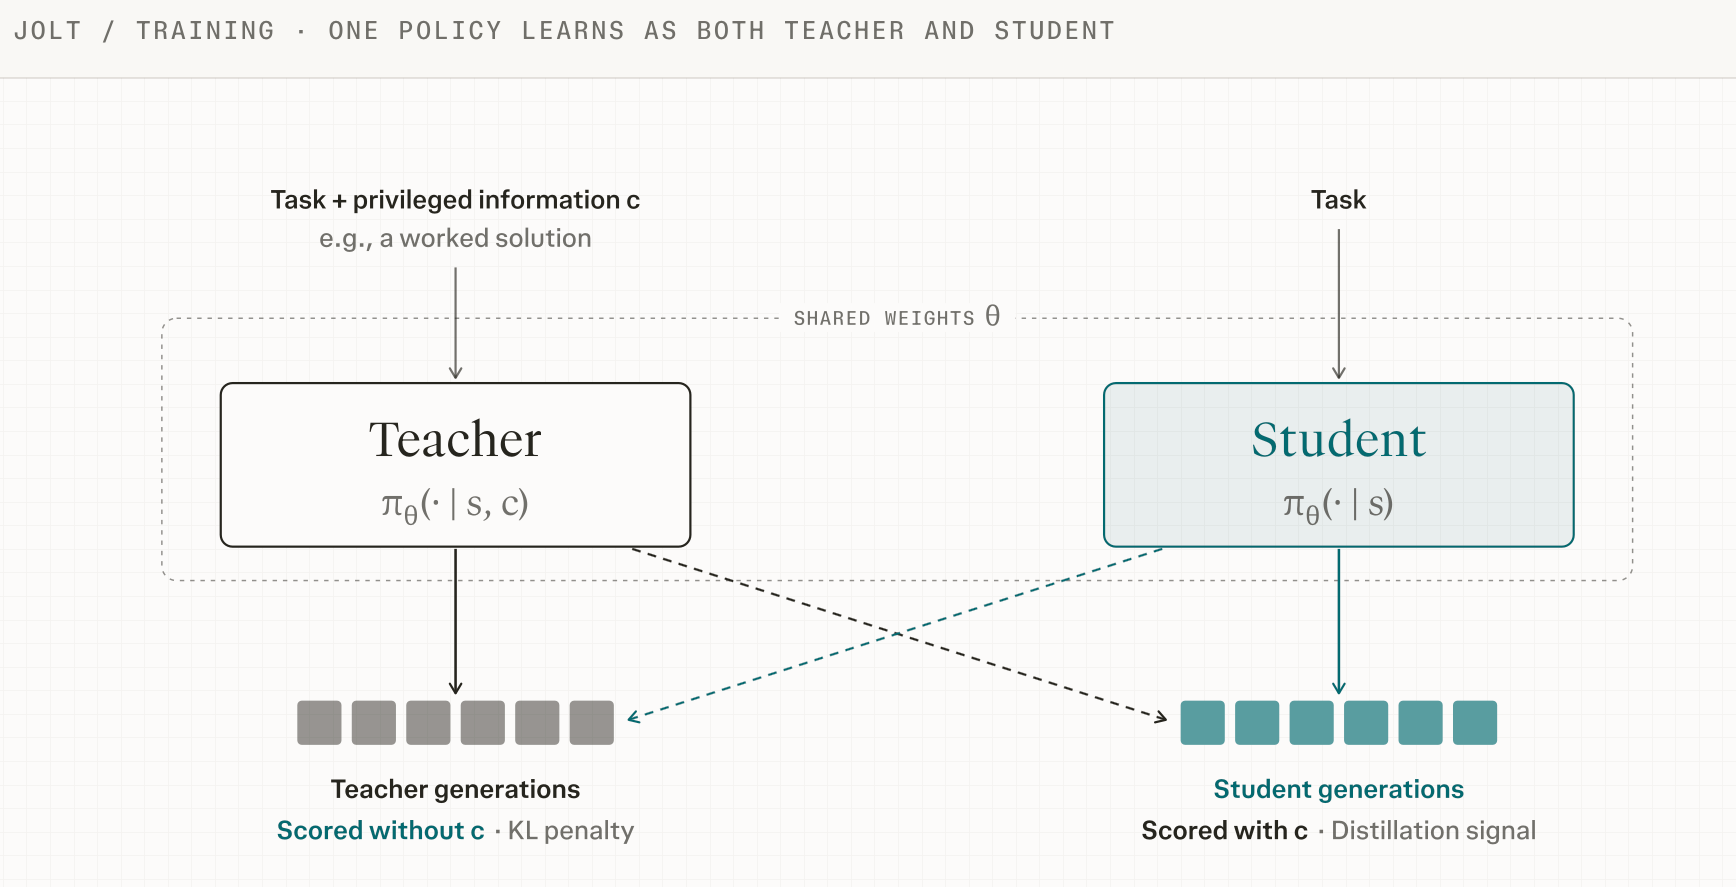
21 октября Perplexity Research совместно с NVIDIA представила метод JOLT (Joint On-policy Learning and Teaching) для пост-обучения языковых моделей. В его основе — одна модель, которая одновременно выступает в роли учителя и ученика. Учитель получает доступ к привилегированной информации, например к проверенному решению задачи, тогда как ученик этой информации не видит. Обе роли обучаются совместно, а качество метода оценивается по тому, насколько ученик способен превзойти учителя.
Обычно рассуждающие модели дообучают с помощью обучения с подкреплением по итоговой награде. Один из распространённых вариантов — Group Relative Policy Optimization (GRPO). Такой подход даёт редкий сигнал: модель узнаёт в основном лишь то, решила она задачу или нет. В длинных агентных сценариях это приводит к большому числу неудачных попыток и, как следствие, к высоким вычислительным затратам.
Более плотный сигнал даёт on-policy-дистилляция, при которой сильная модель оценивает каждый токен, сгенерированный учеником. Однако для этого требуется отдельный учитель, а способность хорошо решать задачи не гарантирует умения давать полезные для обучения объяснения. Самодистилляция, известная как OPSD, устраняет необходимость в отдельной модели: та же система получает доступ к правильному ответу и оценивает собственные попытки.
У этого подхода есть ограничение. Учитель, знающий решение, может предлагать шаги, которые недоступны ученику без аналогичной информации. В таком случае подсказки становятся практически бесполезными, а обучение может ухудшить исходную модель. В экспериментах на Terminal-Bench OPSD показала результат ниже базовой модели при любом количестве попыток.
Как устроен JOLT
Авторы JOLT выводят условие, при котором обновление от учителя совпадает с градиентом ожидаемой награды ученика, и используют его как цель для обучения учителя. Учитель тренируется на собственных попытках с KL-регуляризацией относительно ученика. Это ограничивает его отклонение от поведения, которое ученик в принципе способен воспроизвести.
Ученик при этом обучается с помощью обратной KL-дистилляции, используя оценку каждого токена, полученную от учителя. Дополнительная версия метода, JOLT+, добавляет к этому центрированную итоговую награду самого ученика. Таким образом, система сочетает плотный токенный сигнал дистилляции с обратной связью по конечному результату.
Результаты экспериментов
Метод проверили на пяти наборах данных и пяти базовых моделях — от Qwen3-0.6B до Qwen3-30B-A3B. По данным авторов, JOLT+ превзошёл GRPO на GSM8K на 1,5 процентного пункта, на MATH — на 4,2 пункта, а на LiveCodeBench v6 — на 3,0 пункта. На агентном бенчмарке AppWorld преимущество составило 9,9 процентного пункта.
На Terminal-Bench 2.1 JOLT+ лидировал при любом количестве попыток. Показатель pass@1 составил 10,96%, а pass@32 — 34,83%. При этом чистый JOLT без дополнительной награды ученика уступил GRPO на AppWorld и Terminal-Bench. Лучший результат, согласно исследованию, даёт именно комбинация двух сигналов в JOLT+.
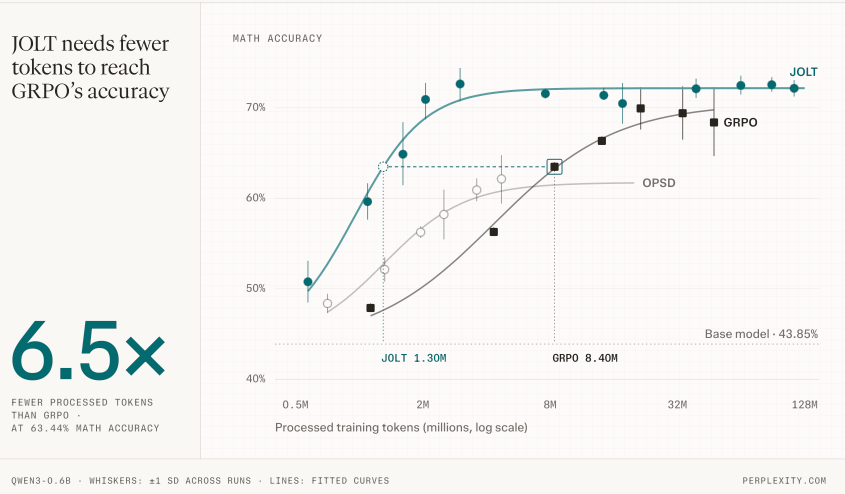
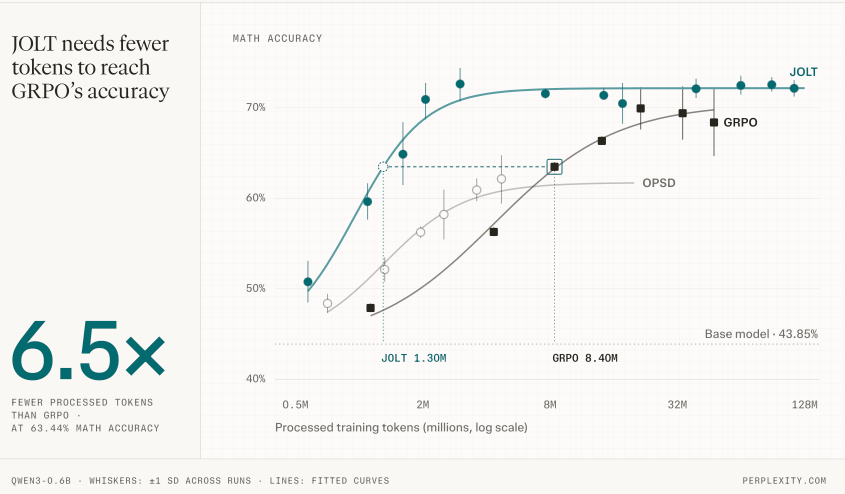
Авторы также сравнили методы по объёму обработанных данных. Чтобы достичь точности 63,4% на MATH, GRPO потребовалось обработать 8,4 млн токенов, тогда как JOLT, судя по аппроксимированной кривой, достиг того же уровня после примерно 1,3 млн токенов. Это примерно в 6,5 раза меньше. Если учитывать только сгенерированные токены, разрыв увеличивается до 13 раз.
Сокращение объёма пост-обучения может быть особенно важным для разработчиков, которые адаптируют открытые модели под собственные задачи. Меньшее число токенов означает снижение затрат на вычисления и сокращение времени экспериментов. Участие NVIDIA также создаёт предпосылки для появления метода в её инструментах для дообучения, хотя компания напрямую этого не заявляла.
Наиболее перспективным направлением выглядят агентные задачи, где разработчики имеют привилегированную информацию: логи успешных запусков, результаты тестов и сообщения верификаторов. Однако результаты пока нужно оценивать осторожно. Все эксперименты проводились на сравнительно небольших моделях, независимых воспроизведений не было, а величина выигрыша заметно различалась между бенчмарками.
Сообщить о проблеме в публикации
Обращение принято Обращение будет рассмотрено. По результатам проверки публикация может быть исправлена, дополнена, временно скрыта или удалена.