Microsoft представила ускоритель Maia 300 для инференса больших языковых моделей
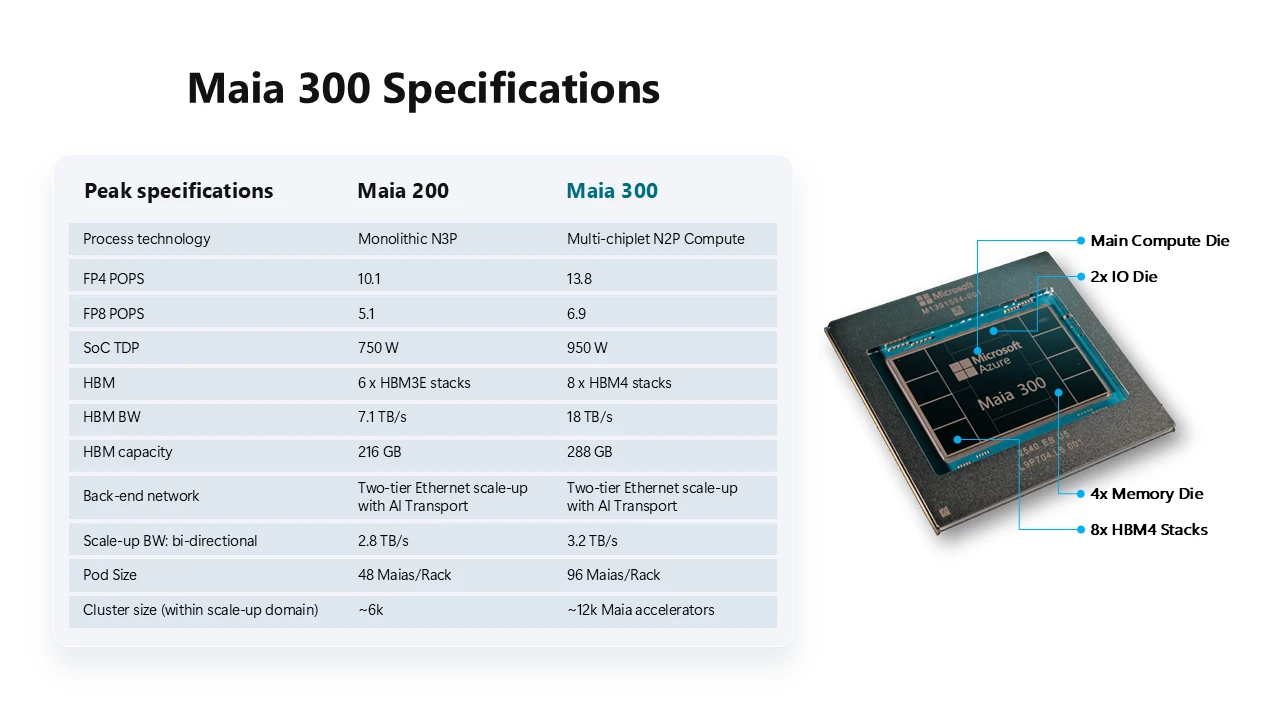
Maia 300 получит 288 ГБ памяти HBM4, пропускную способность 18 ТБ/с и будет устанавливаться в стойки по 96 ускорителей.
Microsoft представила специализированный ускоритель Azure Maia 300, предназначенный прежде всего для инференса больших языковых моделей и генеративных сервисов. В компании позиционируют его как XPU, ориентированный на задачи, где важны не только вычислительная мощность, но и скорость перемещения данных между памятью, вычислительными блоками и сетью.
Разработчики связывают это с распространением агентских сценариев. Такие системы выполняют задачи в несколько этапов, работают с длинным контекстом и регулярно обращаются к внешним инструментам. В результате узким местом становятся пропускная способность памяти и задержки передачи данных, а не только производительность самих вычислительных ядер.
Мультичиплетная архитектура и память HBM4
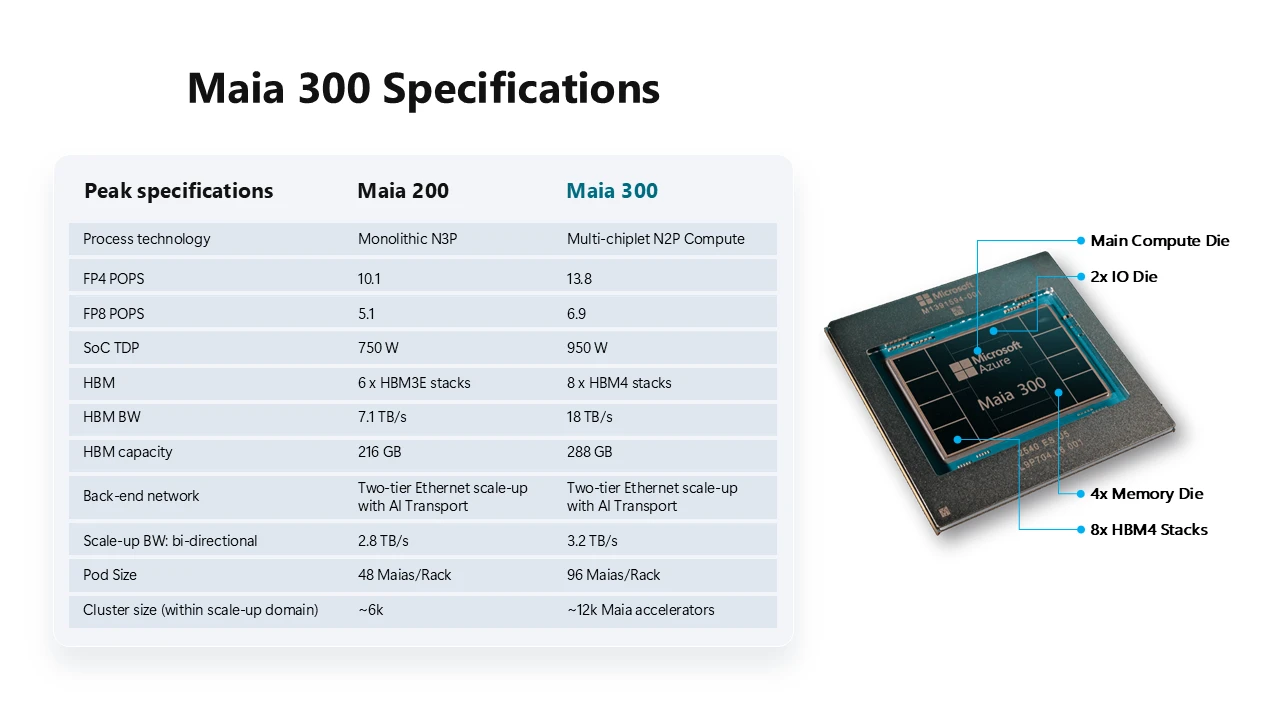
Maia 300 построен по мультичиплетной схеме. Вычислительные ядра выпускаются по техпроцессу TSMC N2P, а архитектура разделяет вычисления, контроллеры памяти и физические интерфейсы ввода-вывода на изолированные домены.
В основе ускорителя лежит архитектура SDLA с программным управлением потоками данных. Она позволяет размещать данные ближе к блокам, которые их используют, и явно контролировать обмен между памятью, вычислительными движками и сетью. NUMA-топология между чиплетами должна уменьшить количество лишних перемещений данных и связанные с ними энергозатраты.
Ускоритель оснащен восемью стеками HBM4 общим объемом 288 ГБ. Пиковая пропускная способность памяти достигает 18 ТБ/с. По сравнению с Maia 200 это означает рост показателя в 2,5 раза и увеличение объема памяти на 33%. Эффективность HBM в расчете на ватт, по данным Microsoft, выросла вдвое при тепловом пакете чипа 950 Вт.
Для инференса предусмотрена поддержка форматов пониженной точности, включая улучшенный MXFP4 и форматы хранения с разрядностью менее трех бит. Более компактное представление данных позволяет экономить память и снижать объемы ее передачи. Это должно упростить работу с длинным контекстом и KV-кэшем крупных моделей, а также увеличить число параллельных сессий при том же энергопотреблении.
Стойки с 96 ускорителями
Microsoft отказалась от классической схемы с отдельными хост-серверами и платами ускорителей. Вместо этого компания использует объединенный вычислительный блок, в который входят четыре Maia 300, хост-процессор, оперативная память, накопители и компоненты жидкостного охлаждения.
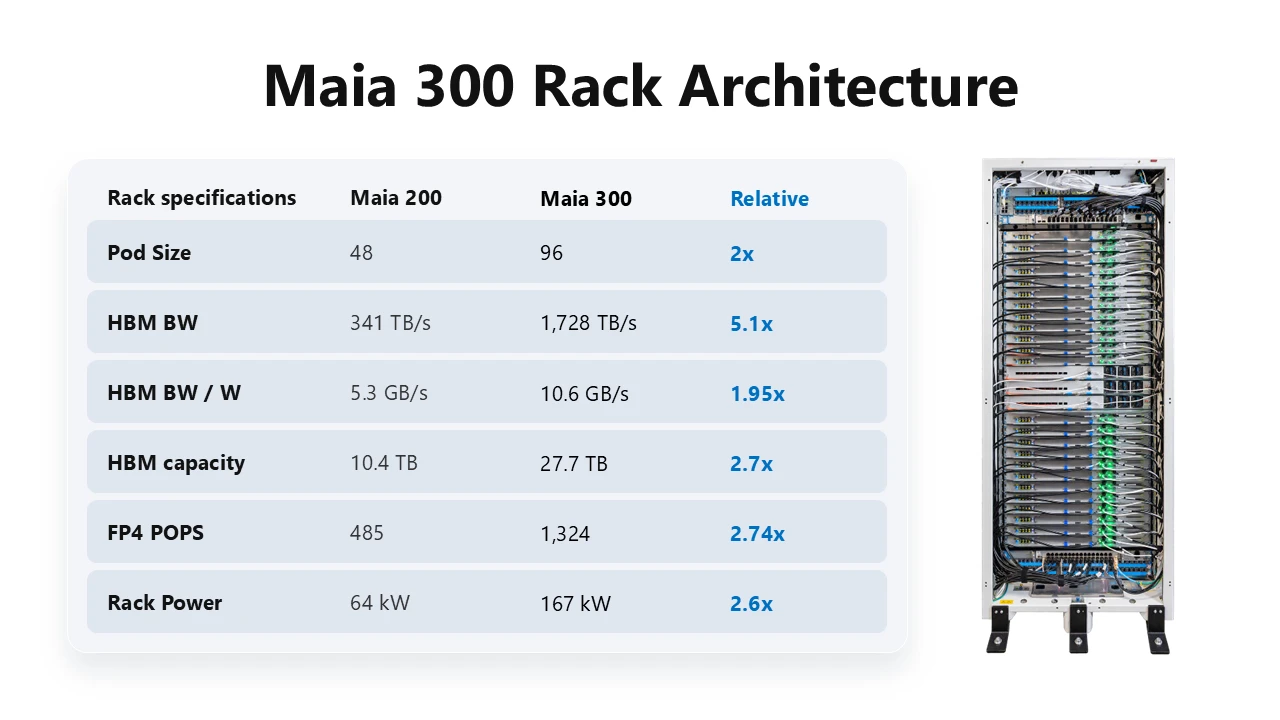
Одна стойка включает 24 таких блока — всего 96 ускорителей и 27,6 ТБ памяти HBM4. Ее суммарное энергопотребление составляет около 167 кВт. Внутри стойки установлены шесть ASIC-коммутаторов, размещенных в трех блоках жидкостного охлаждения. Система может подключаться непосредственно к жидкостному контуру дата-центра либо работать через промежуточные теплообменники «вода — воздух», что должно упростить интеграцию в уже существующую инфраструктуру.
Единая сеть для масштабирования
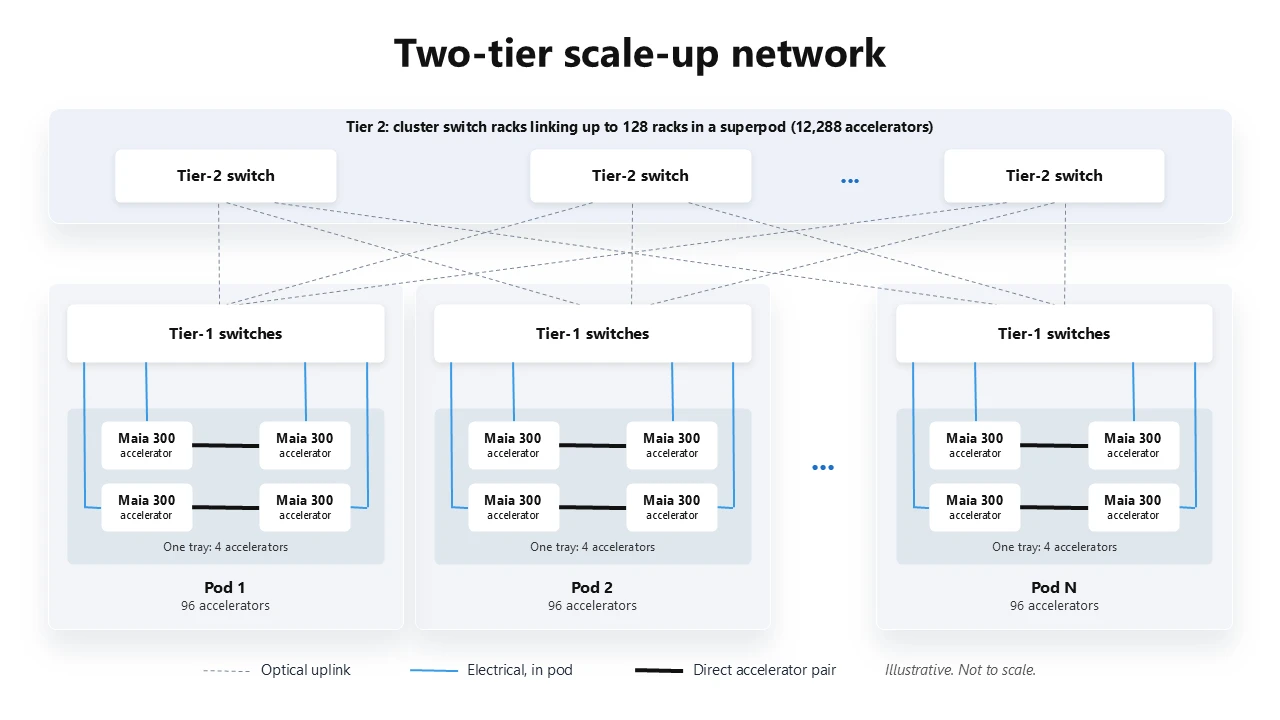
Сетевая архитектура Maia 300 продолжает концепцию SDLA и распространяется за пределы отдельного ускорителя. Microsoft использует единую двухуровневую Ethernet-сеть вместо раздельных доменов scale-up и scale-out.
На первом уровне ускорители внутри стойки соединяются медными линиями. Пары чипов в одном вычислительном блоке имеют прямые соединения, а остальная коммутация построена по полукоммутируемой топологии. Такой подход призван сократить накладные расходы и энергопотребление.
На втором уровне до 128 стоек объединяются оптическими коммутаторами в единый суперпод, включающий до 12 288 ускорителей Maia 300. Полоса пропускания между любыми чипами может перераспределяться и достигать 750 ГБ/с. Тензорный параллелизм при этом можно удерживать внутри стойки из 96 ускорителей, а параллелизм экспертов и конвейерный параллелизм — распределять по всему суперподу.
По оценке Microsoft, на уровне стойки Maia 300 обеспечивает семикратный рост пропускной способности генерируемых токенов по сравнению с Maia 200. Кроме того, ускоритель должен выдавать на 40% больше токенов на мегаватт по сравнению с традиционными GPU-решениями.
Развертывание Maia 300 в промышленной инфраструктуре Azure запланировано на 2027 год. Ускорители станут базовой платформой для инференса в Microsoft Copilot, Teams, GitHub Copilot и других внутренних системах обработки естественного языка.
Сообщить о проблеме в публикации
Обращение принято Обращение будет рассмотрено. По результатам проверки публикация может быть исправлена, дополнена, временно скрыта или удалена.
Читайте новые материалы журнала — свежие сюжеты каждый день.
На главную