Mercury 3 генерирует более тысячи токенов в секунду, но уступает конкурентам в агентных задачах
Inception представила диффузионную модель Mercury 3 с контекстом до миллиона токенов. Первые независимые тесты показали высокую скорость, но проблемы с планированием.
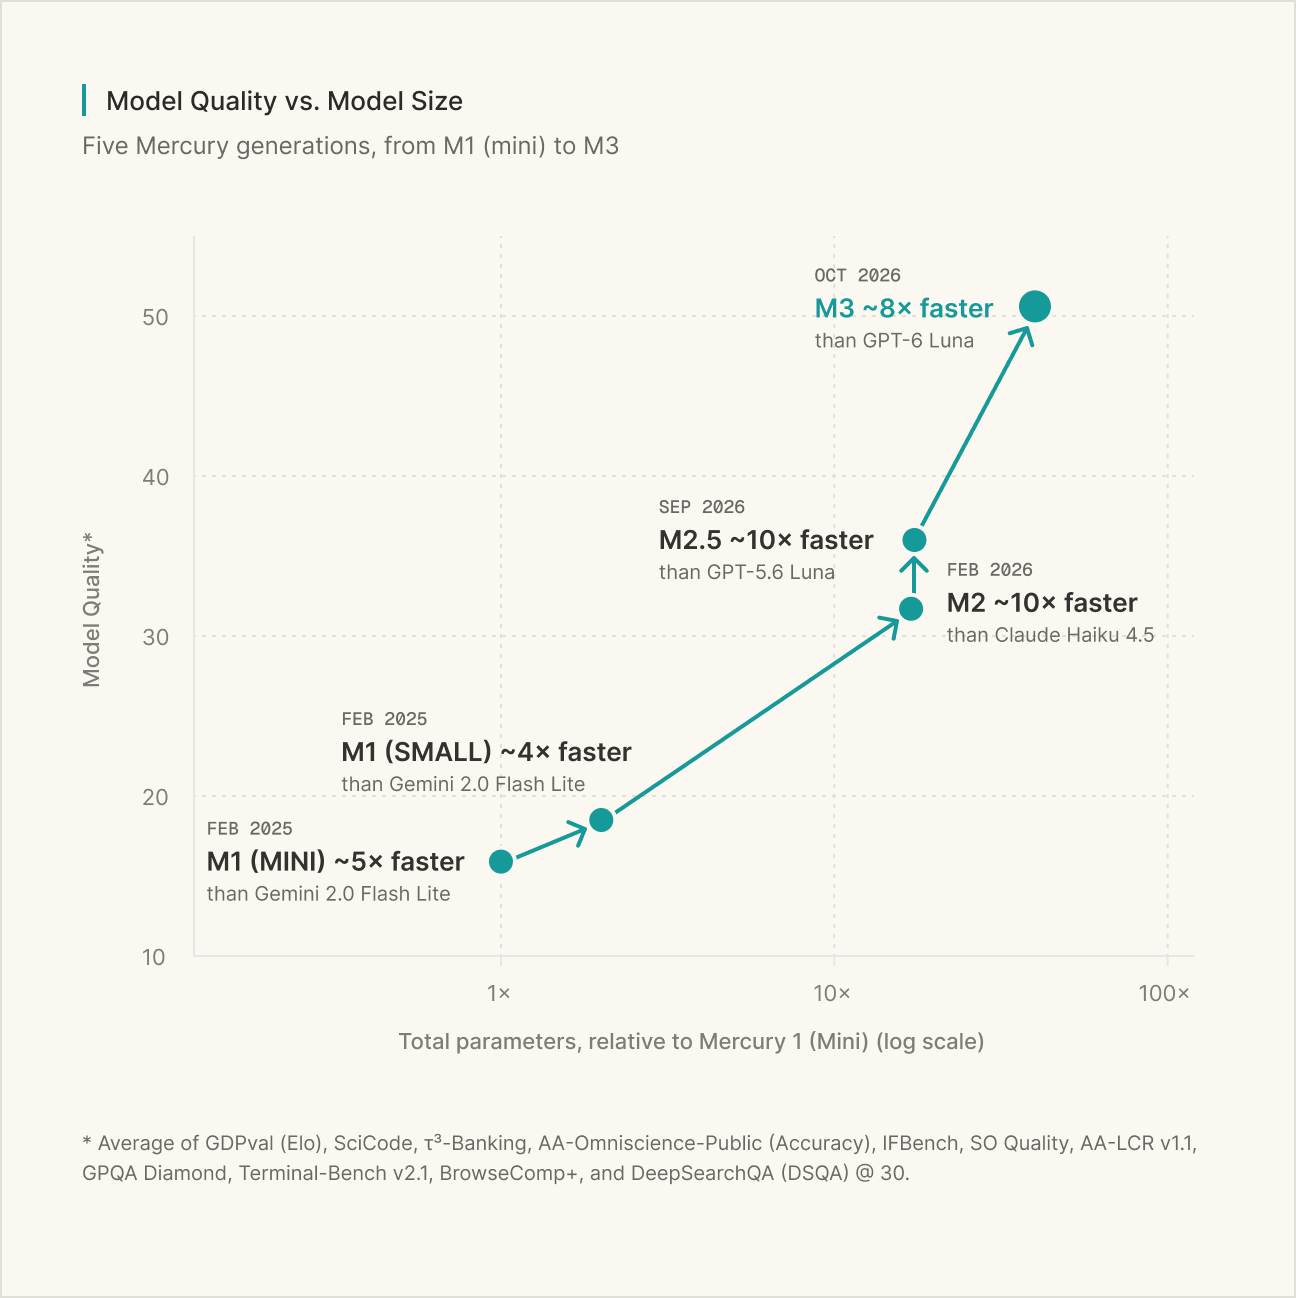
19 октября компания Inception представила Mercury 3, новую версию своей диффузионной языковой модели. По данным разработчиков, на GPU NVIDIA она генерирует 1 068 токенов в секунду. Это в 4–8 раз быстрее моделей своего класса, GPT-6 Luna и Claude Haiku 5.5, при сопоставимом или более высоком качестве.
Mercury 3 устроена иначе, чем привычные LLM. Авторегрессионные модели пишут ответ строго по одному токену слева направо. Диффузионная модель генерирует черновик всего фрагмента сразу и за несколько шагов параллельно его уточняет, примерно как Stable Diffusion проявляет картинку из шума. За счёт этого основное ограничение скорости, последовательная генерация, почти перестаёт работать.
Mercury 3 более чем в 40 раз больше Mercury 1 по числу параметров. Точный размер и детали архитектуры компания не раскрывает.
Контекстное окно выросло с 260 тысяч токенов у Mercury 2.5 до 1 млн.
На стандартных бенчмарках модель, по словам Inception, «втрое умнее» Mercury 1.
API совместим с OpenAI (модель mercury-3) и поддерживает параметр reasoning_effort. Модель доступна через собственную платформу Inception, OpenRouter, Baseten и Vercel AI Gateway. Открытых весов нет.
Бенчмарки по программированию (данные Inception, средние настройки):
На SWE-Bench Atlas новая модель заметно опережает конкурентов. На DeepSWE её обходит Haiku 5.5. В агентном тесте TinyFish на 50 реальных задачах веб-навигации из Mind2Web Mercury 3 выполнила половину. Это, по данным компании, существенно больше, чем у GPT-6.1-Sol, при том же числе шагов и расходе токенов.
Цена: $0,20 за 1 млн входных и $0,70 за 1 млн выходных токенов. На старте действует скидка 50%: $0,10 и $0,35 соответственно. Кэшированный вход на 90% дешевле. Новые аккаунты получают 100 млн токенов бесплатно без привязки карты. Mercury 2 и 2.5 закрыты для новых пользователей, текущие клиенты сохранят к ним доступ до 15 ноября.
Компания позиционирует модель для задач, где важна задержка ответа, например, голосовые ассистенты, поддержка, обучение, браузерные агенты. Таким образом, Octen AI использует Mercury 3 для поиска в умных очках. Медианное время генерации там составляет 0,9 с, полный ответ приходит за 2,2 с.
«Ответ, на который уходит пять секунд, ощущается как катастрофа, — говорит CEO Octen Куан Цзоу.
Все результаты пока заявлены самим вендором, независимых замеров ещё нет. Inception основали профессора Стэнфорда, UCLA и Корнелла Стефано Эрмон, Адитья Гровер и Владимир Кулешов. Предыдущая версия, Mercury 2, вошла в список лучших изобретений 2026 года по версии TIME.
Модель поддерживает tool calling и structured outputs, держит контекст 1M и выдаёт до 131k токенов на выходе. Уровень рассуждений настраивается от none до xhigh (Vercel AI Gateway). Агентный харнесс её подхватит.
Первый независимый замер. Bito 19 октября прогнал Mercury 3 в Claude Code на своих агентных задачах (Bito). Результаты в длинных многоходовых сессиях:
Модель самая быстрая, но заметно уступает по качеству. Хуже всего ей даётся планирование: она на 18 п.п. отстаёт от Sonnet 5.5 и DeepSeek. Лучше всего выходит трассировка кода, 82%. Между сессиями результаты скачут сильнее, чем у других моделей.
В агенте скорость не 1 000 ток/с, а около 200 ток/с. Каждый ход агент заново отправляет контекст на 50–150k токенов, и модели сначала нужно его прочитать. Диффузия ускоряет только генерацию ответа, а в агентах ответы короткие: в среднем 273 токена перед следующим вызовом тула. Всё равно получается примерно вдвое быстрее Opus.
Дешевле на бумаге, чем на деле. Кэш срабатывал плохо: из 5,5 млн входных токенов за сессию из кэша пришёл только около 1 млн. В итоге сессия стоила $0,48, втрое дороже DeepSeek V4.1 Flash при более низком качестве.
Вывод: модель подходит для быстрых и чётко поставленных задач вроде поиска по коду и мелких правок. Для многошагового процесса по планированию и реализации она пока не готова.
И да, Mercury 3 можно подключить в Kodacode через BYOK как OpenAI-совместимую модель.
Попробуйте Kodacode на своём проекте: скачать для IDE, CLI и Desktop. Анонсы обновлений, практические разборы и новости продукта в нашем Telegram‑канале.
Сообщить о проблеме в публикации
Обращение принято Обращение будет рассмотрено. По результатам проверки публикация может быть исправлена, дополнена, временно скрыта или удалена.