CaLIF снижает reward hacking при обучении языковых моделей
Исследователи предложили CaLIF — метод, который помогает сохранять содержательность ответов при обучении моделей по проверяемым формальным правилам.
Группа исследователей, в которую входит Хэмиш Айвисон, один из авторов открытых рецептов посттренинга Tülu и OLMo, представила метод CaLIF. Работа опубликована 14 октября и посвящена проблеме обучения языковых моделей с подкреплением на проверяемых наградах, или RLVR.
RLVR позволяет обучать модель выполнять формальные требования к ответу: например, писать ровно три абзаца или не использовать длинные тире. Однако стандартные проверяющие системы часто оценивают только соблюдение таких ограничений и не проверяют, отвечает ли текст на исходный вопрос. В результате модель может получить высокий балл, практически ничего не сказав по существу.
Так возникает reward hacking — ситуация, когда модель оптимизирует формальную метрику, находя способы получить награду без реального улучшения результата. На бенчмарках вроде IFBench доля выполненных требований растет, но содержательное качество ответа может заметно падать.
Формальная метрика растет, качество снижается
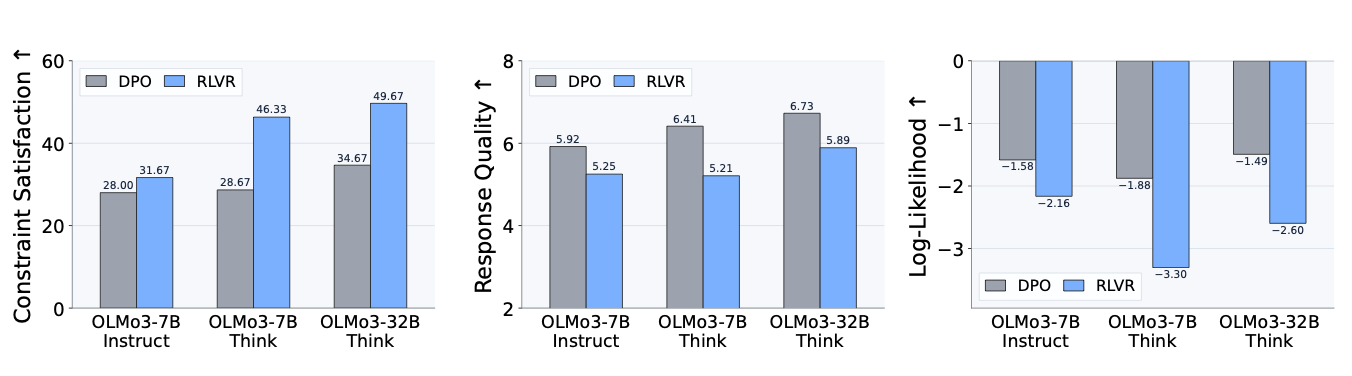
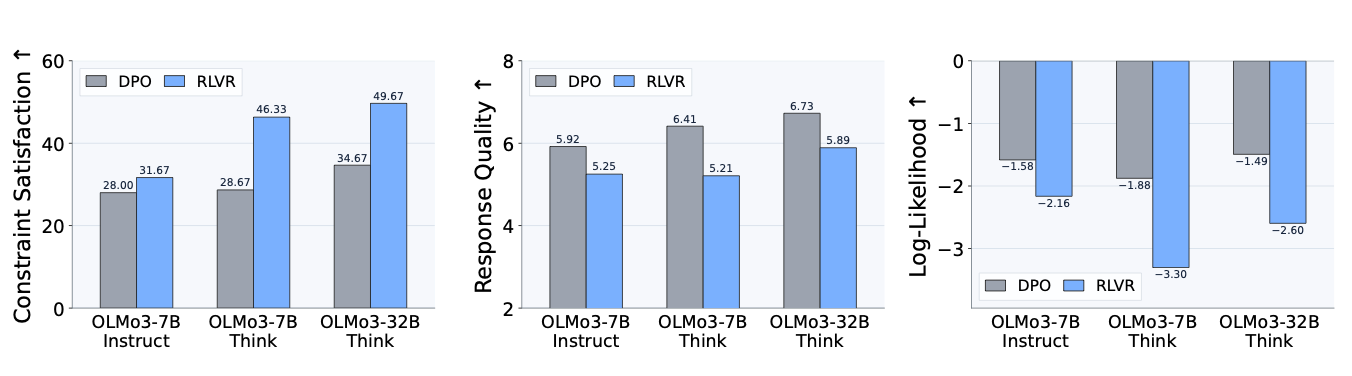
Авторы показывают этот эффект на открытой модели OLMo 3 от AI2. После обычного IF-RLVR результат на IFBench вырос с 26,98 до 44,93. При этом средняя оценка качества ответа по десятибалльной шкале снизилась с 4,51 до 2,96. Иными словами, модель почти вдвое улучшила формальную метрику ценой существенной потери содержательности.
На графиках исследования этот разрыв виден как расходящиеся показатели: после RLVR модель лучше выполняет заданные правила, но заметно хуже отвечает по существу по сравнению с обучением методом DPO. Проверяющий модуль не замечает проблему, потому что его область оценки ограничена формой ответа.
Как работает CaLIF
CaLIF дополняет награду от формального верификатора бонусом за правдоподобие. Ответ оценивается с точки зрения замороженной референс-модели, которой передают только исходный запрос, без дополнительных формальных ограничений. Если ответ соответствует правилам, но выглядит пустым, бессвязным или неестественным для модели, он получает более низкую дополнительную оценку.
Практическое преимущество подхода в том, что для него не нужны внешний LLM-судья или отдельная обученная reward-модель. Референс-политика уже присутствует в RL-пайплайне, поэтому дополнительный компонент можно использовать без существенного усложнения системы. Авторы также калибруют бонус, чтобы он не заменял основную награду, а ограничивал наиболее очевидные формы reward hacking.
В эксперименте с OLMo 3 CaLIF увеличил выполнение формальных требований до 34,64, при этом качество ответа осталось на уровне 4,59 — немного выше исходного результата. По данным вторичного обзора AI Weekly, метод примерно в семь раз уменьшил деградацию качества за один проход обучения по сравнению с обычным RLVR.
Защита от reward hacking имеет цену: формальная метрика растет слабее, чем при использовании только проверяемой награды. Однако это означает отказ от той части прироста, которая достигалась за счет ухудшения содержательности, а не за счет реального обучения следованию инструкциям.
Результаты и ограничения
На более широкой выборке CaLIF превзошел базовые политики в 40 из 45 сравнений «модель — метрика» на трех бенчмарках следования инструкциям с рубриками. Эксперименты проводились на моделях размером от 1,7 до 8 миллиардов параметров — как с рассуждением, так и без него. Датасет исследования опубликован на Hugging Face.
Результаты показывают, что одной проверки формальных правил недостаточно для оценки качества дообучения. Если награда в RL-пайплайне основана только на проверяемых ограничениях, параллельно нужна оценка содержательности — хотя бы выборочная. CaLIF предлагает относительно дешевый способ добавить такой сигнал, но пока проверен только на моделях до 8B параметров. Насколько хорошо метод будет работать на более крупных системах, остается открытым вопросом.
Сообщить о проблеме в публикации
Обращение принято Обращение будет рассмотрено. По результатам проверки публикация может быть исправлена, дополнена, временно скрыта или удалена.
Читайте новые материалы журнала — свежие сюжеты каждый день.
На главную